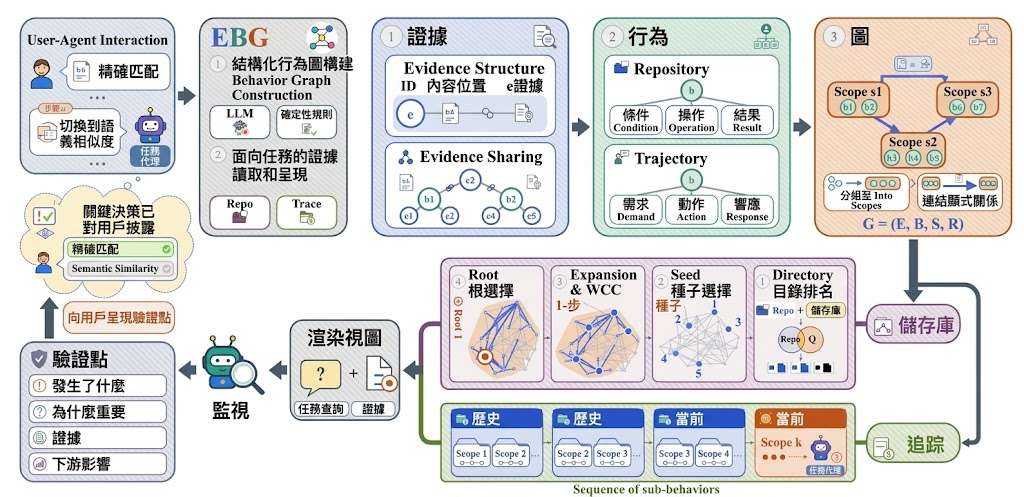
長流程 AI 代理執行軟件工程工作時,使用者往往難以判斷哪些決定會影響結果。Evidence-Grounded Behavior Graph(EBG)是一套 training-free 監察方法,將來源連結證據整理成行為、範圍與關係,協助監察者追查代理做過甚麼,以及相關證據藏在哪裏。
EBG 不只記錄操作次序,而是以 task-oriented views 把要求、觀察到的行為和可能後果連起來,讓人集中核實具影響力的決定。這比逐段翻查訊息、程式碼、工具輸出及中間產物更適合長流程工作,但它仍需要可靠的來源證據和監察模型作判斷,並不會自動保證結論正確。
項目同時提供 AgentMonBench,涵蓋 SpecGAP、SilentSwap 和 FeedbackTrace 三個子集,各有 100 個例子;主要實驗使用 FeedbackTrace Long 的 100 個樣本。基準從兩個方向測試代理監察能力:要求與行為是否一致,以及能否找出需要使用者核實的重大自主決定;網站亦展示八個模型的結果,但儲存庫沒有在摘要中列出完整分數。
- Python 3.11 或以上可執行 EBG,FeedbackTrace 建構需要 Python 3.12,SilentSwap 另需 Docker。
scripts.demo可離線建立合成圖,不需憑證或基準資料,測試結果會儲存至outputs/demo/。- 公開資料包括完整評估輸入、Gold annotations 和樣本清單;預測及 judging 則需自行提供 endpoint、模型 ID 和憑證。
對研究AI 安全監察及軟件工程團隊來說,EBG 的把「代理做了甚麼」轉化成可追溯的證據結構。它目前仍是 under review at ICLR 2027 的研究項目,較適合作為可重現的研究基礎及監察流程原型,而非即插即用的生產系統。