Depth Pro 2:蘋果開源的深度圖兼具度量準確性、銳利度與時間一致性

照片邊緣要清晰,影片深度也要穩定。Apple 用同一套模型兼顧兩者,但焦距與記憶體仍左右結果。

Depth Pro 2 on images: inputs on top, predicted depth below

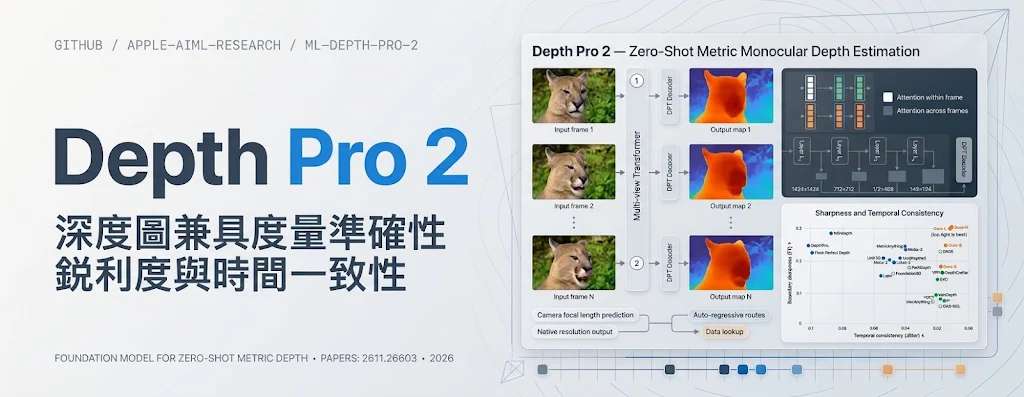
Depth Pro 2 是 Apple AI/ML Research 的開源專案。主要用作深度估算兼處理照片與影片。普通相機拍下的照片、整段影片及即時影像,都能交給同一個流程,按輸入完整解像度估算每個像素的距離以米(meter)制深度計算。處理影片時,預設模式每段讀取 16 frames,相鄰片段重疊 4 frames,讓接合位置的深度保持穩定。這種安排直接處理影片合成的麻煩:物件輪廓要清楚,前後影格的遠近判斷也要連貫。

離線影片可以先收集片段,再一起預測;相機畫面則要隨影格抵達立即處理。unbuffered 模式會使用當前影格及之前 15 frames,代價是串流開頭可參照的畫面較少,深度較不穩定。加長片段及增加重疊可稍為改善穩定性,但執行會更慢。因此,即時預測描述的是處理方式,項目提供的資料未列出可通用的速度保證。

前後畫面能互相參照,靠的是模型內部共享資訊。transformer 在首三分之一的 blocks 之後,交替處理影格內與跨影格的 attention,即輪流查看單張畫面的細節與前後畫面的關係。這讓影片預測有機會利用其他影格的線索,而非把每張畫面獨立處理。保留原始解像度則服務另一個目標:讓物件邊緣維持清晰,減少輪廓細節流失。

項目以 Sintel 與 Spring datasets 的平均結果,檢查清晰度與時間穩定性。Boundary F1 score 衡量輪廓是否準確,Jitter 則反映深度隨時間的抖動;項目報告兩者均優於既有單影格及多影格方法,但未列具體分數。影片展示採用 2K–4K 來源,Depth Pro 2 H+ 保留原生解像度,其他方法使用各自預設設定。這能比較各套系統的輸出,卻不能單憑畫面把差距全部歸因於網絡結構,因為解像度設定也不同。

要把遠近變成米數,焦距必須可靠。未知焦距時,系統會先估算;影片採用首個 window 內估算值的中位數,即時串流則在首個 window 填滿後固定焦距。項目文件明言,焦距高估 10%,所有深度也會高估 10%,所以畫面穩定並不等於尺度準確。已校準相機可先校正影格畸變,再透過 Python 傳入水平焦距 fx,跳過焦距估算。

剪接與合成團隊可以先看預設彩色結果,紅色代表近,藍色代表遠,再決定是否輸出資料。需要接駁 Nuke 或 Blender 時,可輸出 16-bit inverse depth,即越近越亮的反向深度圖,並以原始資料方式讀取。這種輸出按照片或影片首個影格的深度範圍縮放,後續更近的點會飽和成白色;要保留米制深度及焦距,應改取 NPZ。製作點雲前也要裁剪深度範圍,因為天空可能被估為無限遠或數公里。

本機測試可在 Linux 或 Apple silicon Mac 準備 uv,下載程式及模型權重,再交入照片或影片。系統會選用可用的 NVIDIA GPU、Apple silicon GPU 或 CPU;模型由 S、B、L 到預設 H+,較小型號較快,較大型號的深度較清晰穩定。記憶體需求隨影格尺寸及 window 增長,放不下時應先縮短 window,再考慮較小模型。大幅縮小輸入會失去細節,甚至改變深度尺度,不能只當成無損的加速方法。

Apple 亦提供 Core ML 模型及相機深度 Mac demo,後者需要 Apple silicon、macOS 15 或以上,以及 Xcode 16 或以上或其 command line tools。研究團隊可先用固定相機片段,檢查輪廓、時間穩定性及已知距離是否吻合,再接駁合成流程。儲存庫未附 training 或 evaluation code,輸入亦未交代維護節奏;模型權重限非商業科研及學術開發,商業製作不能直接沿用。

模型選擇直接影響速度、邊緣細節及穩定性:大型號較清晰穩定,小型號較快。以下列出參數、權重下載大小及選擇方向。

型號參數下載大小選擇方向
S24M97 MB手提電腦先測試,優先考慮速度
B97M386 MB從 S 往上比較品質與負擔
L334M1.3 GB較偏向細節與穩定性
H+872M3.5 GB預設型號,優先考慮輸出品質

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, NVIDIA, Video, Image, Mac, Linux, Python, 庫, 蘋果

EgoCaptioner:全面而細緻的第一身影片描述

影片字幕常說得出發生甚麼,卻未必交代動作先後。EgoCaptioner 把整體場景和帶時間標記的步驟放在同一份描述內。

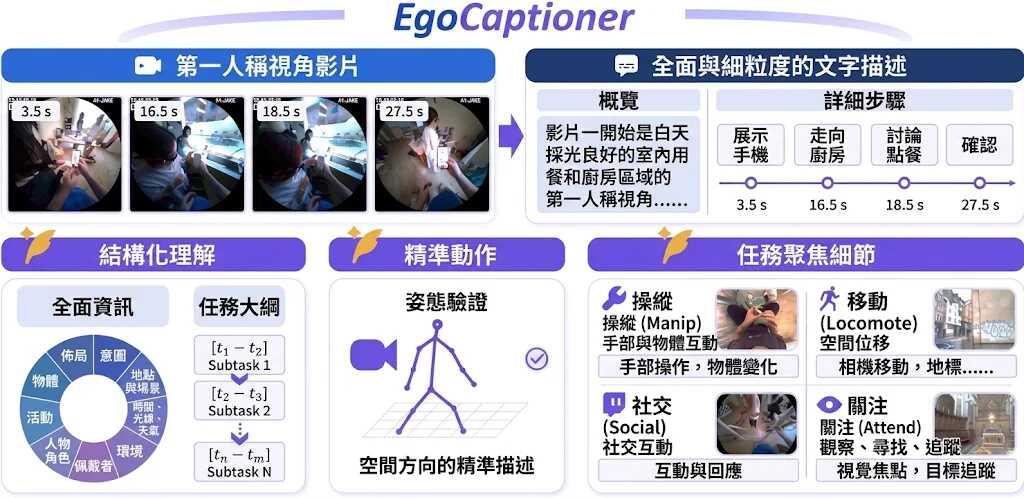
EgoCaptioner overview

EgoCaptioner 是一套第一身影片描述模型,將場景總覽與帶時間標記的活動步驟配成一份字幕,涵蓋手部操作、移動、社交互動和視線注意。它以 Qwen3.5-9B 為基礎,由 KlingAI Research、北京大學等團隊參與開發。

在五個第一身影片基準測試中,EgoCaptioner 的 EgoMe-Steps METEOR 為 12.26;同表最佳開源模型 Qwen3.8-27B 為 7.24。這項比較反映步驟描述的文字重合度,不等於每段影片都能準確還原事件。其他指標也有落差:EgoMe-Overview 的 CIDEr 是 0.65,低於同表 EgoThinker 的 4.85,顯示總覽描述並非所有面向都領先。

你可按任務選擇完整描述、只產生影片總覽,或搜尋指定活動並列出步驟。指定活動時,event_steps 必須同時提供 event;活動重複出現,可在簡短英文描述中補上前後情境,並以「I」代表佩戴相機的人。單段影片推理會把結果印在終端,也可另存文字檔;批次模式則以 JSONL 一行一項任務,影片路徑相對於該檔案,處理完成後逐項寫入結果。

這套模型的優勢不只在輸出格式,也可用在訓練資料如何被建立。因此你可先整理事件結構,再逐步補上時間標記和細節,從八個第一身影片來源製作 50,000 個訓練例子;這種由粗到細的標註,目的是避免一次寫完整段影片時漏掉短暫動作或弄亂次序。有感測資料的影片還會加入由人體姿態推得的動作事實,為描述提供另一個核對依據。

生成後的描述亦會透過強化學習調整。Group Relative Policy Optimization(GRPO)是一種以多項獎勵引導模型修訂輸出的訓練方法;EgoCaptioner 用事實準確度、內容涵蓋度和步驟時間對齊作評分,並扣減零碎或重複敘述。消融實驗支持事實獎勵與時間獎勵各自補足對方,也顯示由粗到細的標註比一次完成的標註提供更有效監督;項目文件沒有列出這些消融的具體分數。

EgoTempo 的準確率為 38.40,低於 GPT-6-Astra 的 52.60;但在 Minerva-Ego 的 caption-to-QA 測試中,EgoCaptioner 得分 18.57,高於同表最高對手 EgoThinker 的 15.71。PhysCapBench 的 Overall 得分為 78.84,也高於 Gemini 3.1 Pro 的 75.06,惟仍低於 GPT-6-Astra 的 84.87。這些結果說明它在特定字幕與問答評估上有優勢,不能概括成全面勝過商用模型。

部署門檻主要在硬件和執行環境:需要 Linux x86-64、支援 BF16 的 NVIDIA Ampere、Ada 或 Hopper GPU,以及兼容 CUDA 12.8 的 driver。單段影片流程還要 CUDA toolkit、nvcc 和 C++ compiler;批次處理則另用 vLLM。若 TorchCodec 找不到 FFmpeg 的共享程式庫,需在執行推理的同一個 shell 設定程式庫搜尋路徑;更換模型或輸入檔時,亦要改用新的輸出路徑。

研究團隊把這套模型定位在第一身影片的細粒度描述,較直接的使用情境是整理佩戴相機的操作紀錄、活動片段或逐步字幕,再由人核對關鍵時間和動作。它對未有感測資料的影片,少了姿態推得的動作事實作輔助;指定活動若描述含糊或影片中多次出現,也需要加入上下文才能選中目標片段。

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 香港科技大學, 南京大學, 北京大學, AI productions, 模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Gemini, Video, Linux, 庫, 強化學習

Coda:由程式碼驅動的影片生成藝術家

鏡頭回到原位,掃走的落葉應該消失;人物伸手的一刻,逐隻手指建模卻可能令動作變僵。

banner

Kling Team 的 Coda 研究系列用程式碼為影片安排場景和動作。當中的 Coda-DaVinci 會判斷哪些細節需要預先固定,哪些可以交給影片模型發揮。拍切開年糕、拆去包裝的過程時,系統先為涉及的物件建模,手指怎樣彎曲、怎樣抓住包裝,就留給影片模型生成。

研究團隊把主比較的影片合成模型統一為 Seedance 2.5,讓讀者看到加入場景控制後的差別。在 T2AV-Compass 隨機抽取的 200 個任務中,直接生成的視覺指令遵從得分為 65.11,Coda-DaVinci 達 67.99。比較畫面真實感,則以直接生成的 71.38 較高,Coda-DaVinci 得 70.26。同一批影片分開評分,才看得出跟足指令和看起來自然之間的取捨。

需要控制場景時,Coda-DaVinci 會先製作 proxy,即一段用簡化 3D 物件演出動作的參考短片。環境和有明確形狀的物件會保留較多結構,人物只保留粗略輪廓,可模擬的物件互動則交給 Blender 處理。當任務講求自然的身體動作,場景位置又毋須精確控制,系統會選擇直接生成,避免成片沿用參考動畫裏僵硬的姿勢。

參考短片交代了物件怎樣移動,外觀仍要另外指定。負責編寫提示詞的智能體先檢視渲染結果,把外觀參考圖逐一對應到場景裏的人物或物件,再寫明成片要呈現的細節和人物動作。對需要反覆改片的製作團隊,共用工作區會保留場景程式碼和素材;審查者可對照同一時刻的畫格,追查應該改動場景、提示詞還是參考圖。

長片尤其考驗這套修訂方式,因為事件即使依序發生,轉場時仍可能偏離原來的場景設定。團隊測試了 29 個 LongAV-Compass 案例和 50 個 WBench 案例,報告指長片的事件完成度、結構及互動一致性有所改善,但未列出改善幅度。與直接生成相比,Coda-DaVinci 在轉場穩定性及跟隨場景設定兩方面仍然吃虧。

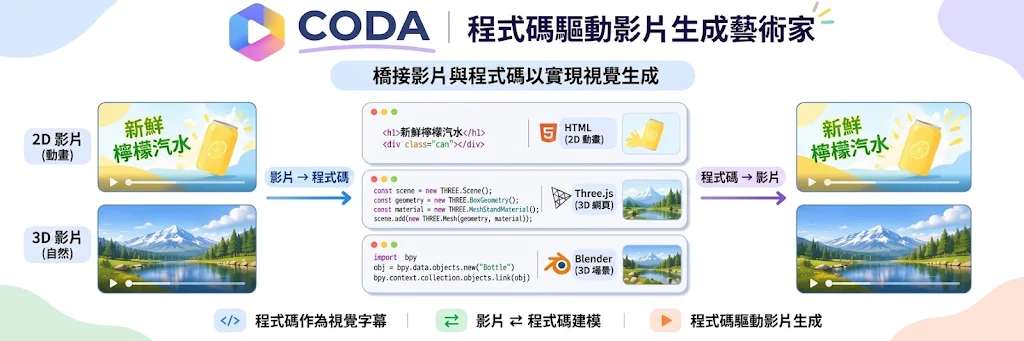
系列中的 CodeCap-Bench 把問題倒過來,看模型能從一段結構清晰的 2D 影片讀出多少內容。模型看過原片後,要以 HTML、CSS 和 JavaScript 寫出能重新播放畫面的程式。測試要求所有可見內容都由程式繪製,禁止貼入原片畫格或外部圖片,這樣才看得出程式本身記下了甚麼。

研究人員把程式渲染成影片,再與原片對照,既看畫面是否相似,也查物件有否在正確時間出現在正確位置。在已測試的設定下,程式比自然語言描述保留更多資訊。研究人員用重建影片測試問答,得到的答案也較準確,為單看畫面相似度提供了另一種核對方式。

想評估能否把流程接入製作環境,可先在項目首頁同步播放同一任務的成片和 3D 參考短片,對照拆包裝時物件的位置與手勢。系列總表將框架列為 2026/11 已發布,獨立介紹仍寫着 Coming soon,論文在首頁亦標作 forthcoming;本地安裝步驟和硬件需求仍待確認。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 南京大學, 北京大學, 清華大學, AI productions, 模型, Video, Image, 提示詞, 框架, 香港, 3D, Anthropic, 動畫

WeMM Video:讓影片理解同時聽見原始音軌

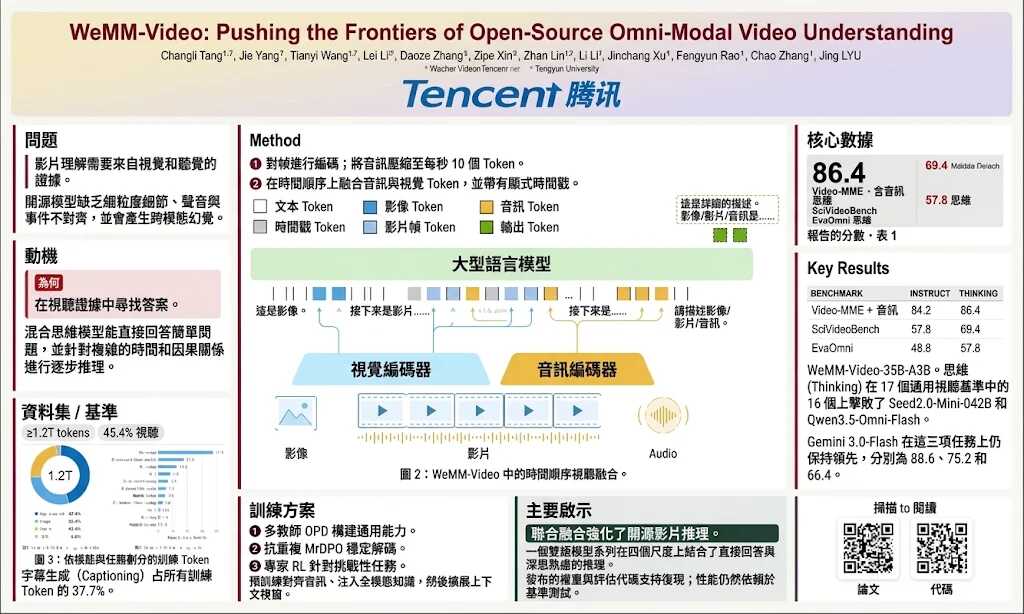
看懂畫面未必聽懂對白。WeMM-Video 把影片畫格與原始音軌一併交給模型分析,並提供不同規模的開源版本。

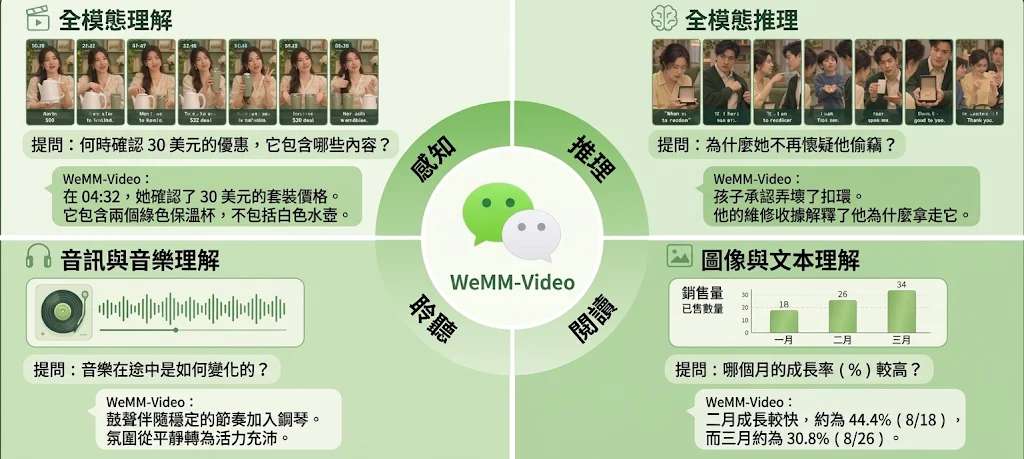
WeMM-Video examples of audio-visual understanding and reasoning, audio and music understanding, and image and text under

同一段影片,畫面和聲音可能各自藏着不同的意思。WeMM-Video 是 WeChat Vision at Tencent 開發的中英雙語多模態模型系列,可讀取文字、圖片、音訊和影片,再以文字作答;分析影片時,它把原始音軌和畫面一併輸入。它提供 2B、4B、9B dense models,以及 35B-A3B mixture-of-experts model,適合從單一媒體辨識延伸至視聽推理的工作。

測試影片理解時,使用者可比較只輸入畫面與同時輸入畫面、音軌的回答,檢查語音資訊會否改變對場景的判斷。項目文件的 Transformers 範例以 2B BF16 checkpoint 生成最多 128 個 tokens;影片取樣設為 1.0 fps,最多抽取 16 幀。這些是範例設定,不代表不同片長或硬件下的速度、準確度保證。

使用 Instruct mode 可取得快速直接的回答;需要明確多步推理時,則改用 Thinking mode。這個分工讓簡單描述不必每次都採用較長的推理流程。模型以約 1.2 trillion multimodal tokens 訓練,經過 progressive pre-training 和 multi-stage post-training;項目文件稱 35B-A3B 在 omni-modal video understanding 上勝過 Qwen3.5-Omni-Flash 和 Seed2.0-Mini-0428,並縮窄與 Gemini-3.0-Flash 的差距。

影片畫格、時間資訊、音訊與文字會一同送入模型處理,因此它可以回答畫面內容,也能把對白納入場景理解;另有 35B-A3B 和 9B 兩款在 general audio understanding 上取得領先表現的說法。

我們需要用 Transformers 載入 BF16 模型,或以 patched vLLM、patched SGLang 提供服務。兩個服務後端都可透過 POST /v1/chat/completions 接收 video_url,並以 video_url.use_audio 決定是否納入原始音軌;模型清單另有 FP8 Block128、AWQ W4A16 和 NVFP4 W4A16,Patched vLLM 支援這些格式。GGUF Q4_K_M 則要透過 Native runtime 執行,文件列出 CPU 或 CUDA 路徑。

測試需要 Python 3.12、NVIDIA GPU、相容 CUDA 12.9 的 driver、FFmpeg,以及 TorchCodec 所需的 shared libraries;Transformers 範例還會下載模型 checkpoint。服務端可按文件指定的 vLLM 0.18.0 CUDA 12.9 或 SGLang 0.5.16 CUDA 12.9 環境啟動,兩者的 context length 範例均為 8192。團隊若先做小規模驗證,可從 2B checkpoint 和內附文字、圖片、音訊、影片例子開始,再按部署後端選擇模型格式。

輸入上限也會影響測試設計:在已設定的 context length 內,每個 request 最多接收 4 張圖片、2 條影片和 2 個音訊項目。長影片若超出抽幀設定,模型看到的只是抽樣畫面;而文件未提供各量化檔案大小和硬件資源需求,現階段難以只靠型號判定部署成本。處理大量片段或要逐幀核對事件的團隊,應先以自己的影片長度、音軌和併發量測試,再決定模型規模與服務方式。

GitHub

Categories: 開源, 騰訊, AI productions, 模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Gemini, Video, Image, Audio, Python, 語音

WeVisForensics:按線索逐段鑑別影片真偽

生成影片的破綻可能只閃現一瞬,整段一併判斷容易漏看。WeVisForensics 會選擇檢查項目和時間,再決定何時作結。

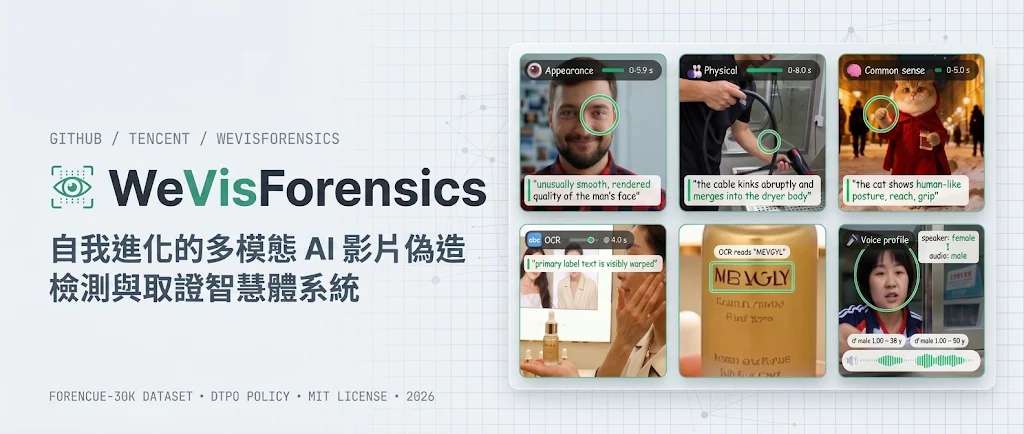
Teaser

WeVisForensics 是騰訊 WeChat Vision 團隊開發的影片鑑偽 agentic framework,負責判斷 AI 生成影片是真實還是偽造,並交代局部證據。它的 WeVisForensics-DTPO 在四組基準的平均準確率為 95.2%,高於既有方法中平均最高的 VideoVeritas(86.2%);兩者的比較條件是 GenBuster-Bench、GenBuster-Bench++、MintVid General 及 AgenticCue。

這種結果不只是單一模型看完整段影片後給答案。WeVisForensics-4B 在 GenBuster-Bench++ 的準確率為 97.5%,該項最佳既有方法為 91.4%;但在 MintVid General 的 Wan2.5 測試中,BusterX++ 為 87.3%,WeVisForensics-DTPO 為 85.6%。這個落差提醒使用者,整體平均領先不代表每種生成器或測試條件都佔優。

調查由 investigator 負責:它先以每秒一格讀取最多 16 格畫面,每一步輸出一個 JSON action,選擇呼叫檢查員,或直接回答 real/fake。它會先讀取檢查結果,再安排下一步,並在五步內作結。相較一次 chain-of-thought 推理,逐次選擇檢查項目和時間窗,較能追查只出現片刻或局部的痕跡;預先固定的多 agent 流程則較難因應不同影片改變檢查方向。

視覺檢查員會以每秒兩格解碼指定時段,回報判斷、信心程度和簡短觀察。visual_appearance 檢查紋理、邊界、閃爍與光照;physical_consistency 查看動作、身體結構、接觸和物料。common_sense 追查事件次序與因果,ocr_consistency 則在指定時間偵測文字,再檢查裁切出的字形。這些分工讓每個檢查員只報告自身能核對的線索,減少把所有判斷混在同一段推理的情況。

影片有人物說話時,voice_profile 會比對聲音與畫面人物的年齡、性別和情緒;asr_analysis 會檢查逐字稿內容及時間。研究設計的出發點是生成痕跡種類不一,而且可能只存在短片段,因此 investigator 要選擇檢查角色、時段與停止時機。若只提升調查策略,固定不變的檢查員仍可能看漏細微痕跡;DTPO 因而讓兩層 agent 共用互動回饋,較快更新 investigator,並以標註過的痕跡時段引導檢查員較慢更新。

訓練資料 ForenCue-30K 結合不同角色的鑑證標註和互動紀錄,分別訓練檢查員執行檢查,以及 investigator 協調檢查。這套資料安排針對的不只是「看過哪些痕跡」,也包括「何時叫哪個檢查員」;不過項目文件沒有提供獨立消融數字,不能據此判定每個訓練環節各自貢獻多少準確率。

使用方式取決於測試規模。單 GPU vLLM 配置以一張 24 GB GPU 共用 Qwen/Qwen3.5-4B,透過 LoRA adapters 切換角色;多 GPU 配置則為各檢查員分配獨立 vLLM server,面向大規模評測。Transformers 配置同樣需要至少 24 GB GPU,OCR 在 CPU 執行,並須使用獨立環境,因為 demo 指定 PyTorch 版本。Gradio demo 可上載影片並選取最長 16 秒的時段;沒有 GPU 時,可重播 demo/examples/ 內十個案例,但這不等同現場推論。

研究結果仍要按測試範圍解讀:GenBuster-Bench 是訓練時同類測試,GenBuster-Bench++ 與 MintVid General 檢查不同基準或生成器,AgenticCue 則測試調查流程。項目文件亦記錄 WeVisForensics-SFT 的平均準確率為 91.3%,低於 WeVisForensics-DTPO 的 95.2%;不同基準的結果並非每項都勝過最佳對手。項目文件的 2026-11 公告稱 4B LoRA weights 已發布,但待辦清單仍把 Hugging Face 權重及 AgenticCue benchmark 列作未完成,下載與重現前宜核對實際檔案狀態。

項目主頁 · GitHub · 模型

Categories: 開源, 南京大學, 騰訊, Agentic, AI productions, 模型, 多模態模型, 模型訓練, Qwen, Google, Video, Audio, 框架, Python, 語音, LoRA

Jeveration:System 1 模型也能生成圖像

整張圖一次生成,還能共用權重做改圖與場景分析;Jeveration 的速度亮眼,但硬件與訓練範圍都有條件。

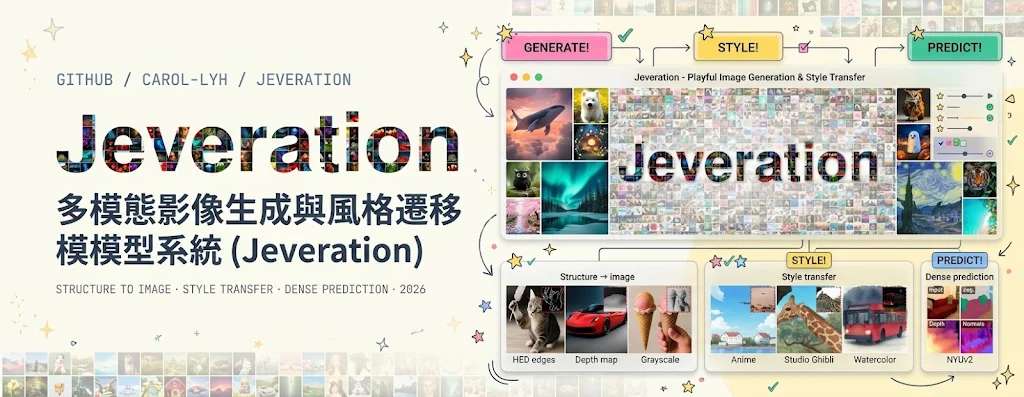
Images generated by Jeveration: text-to-image, image-to-image and dense prediction

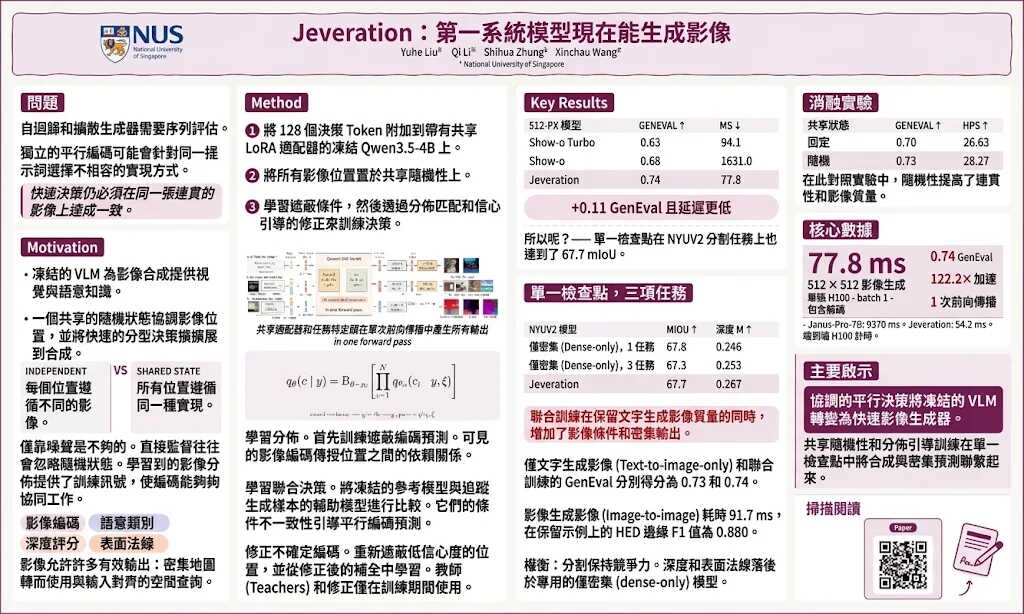
Jeveration 是建基於凍結視覺語言模型的影像生成模型,同一份 checkpoint(模型權重)兼顧文字生圖、改圖及逐像素分析。在單張 NVIDIA H200、batch 1 並計入 decoding 的測試中,生成一張 512 × 512 圖像需 77.8 ms,是所列比較模型中最快。這個數字反映指定硬件上的單張延遲,不能直接當成一般顯示卡或多人服務的速度。

Jeveration 的速度分別為 Janus-Pro-1B 的 98 倍、Janus-Pro-7B 的 122 倍。各模型在同一張 H200 上計時,但使用各自公布的 sampler、步數及解像度,因此比較包含生成流程的差異。Jeveration 的 GenEval 為 0.74;這項指標檢查圖像是否符合文字要求,但輸入資料未列出完整品質排名,不能據此判定它的畫質最佳。

速度來自生成次序的改變:Autoregressive models 逐個 token 生成,diffusion models 則反覆去噪。Jeveration 在一次 forward pass,也就是模型處理一次輸入的過程中,並行選出整張圖的 128 個 codes,這些是代表影像內容的離散編碼。同一段描述可以畫成不同構圖,各位置獨立選擇便可能拼出互不相容的區域。模型因此為每張圖抽取一個 random state,讓所有位置共用同一份隨機條件,協調整體構圖。

只拿目標圖像來訓練,模型卻傾向忽略這份隨機條件。研究人員先讓模型填補被遮蔽的影像編碼,學習各部分如何互相依賴,再由這個第一階段模型判斷生成樣本,引導第二階段的整體選擇。這個安排處理的是「並行選擇能否一致」,而不只是把原有生成步驟刪短。第一階段模型只在訓練時參與,正式生成仍維持一次 forward pass,沒有把判斷程序加回每次請求。

支撐各項任務的是凍結的 Qwen3.5-4B,主模型參數保持不變,再透過共享 LoRA adapters 學習任務所需的調整。不同輸出部分會把模型的決策轉成影像編碼,或逐像素的場景資訊。對需要同時試做生圖、改圖和影像分析的團隊,共用權重可讓原型集中在同一條 pipeline;不過,文字生圖與改圖仍分別使用不同 decoder,把編碼還原成圖像,整套系統並非只有一個權重檔。

改圖時,使用者可提供白線黑底的 edge map,或亮處代表近距離的 depth map,再加文字描述生成影像;亦可先由相片計算這些結構圖。項目另支援灰階相片上色,以及 anime、ghibli、watercolor 風格轉換,讓試作流程涵蓋結構控制與外觀修改。逐像素分析則輸出類別、以米為單位的深度,以及表面朝向,但訓練資料來自 NYUv2 室內場景。道路、戶外景觀等輸入超出這個訓練範圍,不能把室內結果直接當成那些場景的可靠度證據。

本機執行需要 Python 3.12、CUDA GPU,以及 requirements.txt 列出的依賴,下載至 weights 的項目檔案共 6.5 GB。首次執行還會從 Hugging Face Hub 下載 Qwen3.5-4B、TA-TiTok tokenizer 和 CLIP 的 text tower,因此這個容量並不代表全部準備工作。想先檢視效果,可安裝 Gradio 後透過 app.py 開啟瀏覽器示範,三類任務都有範例;整合程式則可使用 JeverationPipeline。項目文件未交代最低顯示記憶體需求、release 節奏或 issue 活躍度,部署前仍要在目標機器驗證。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 模型訓練, Qwen, NVIDIA, OpenAI, Image, 軟件, Python, LoRA, Tokenize

Tideway:讓消費級裝置高效執行 MoE 推理

模型放得進 SSD,生成時仍可能卡在搬運權重。Tideway 按推理階段調整記憶體分工,減少等待。

Tideway

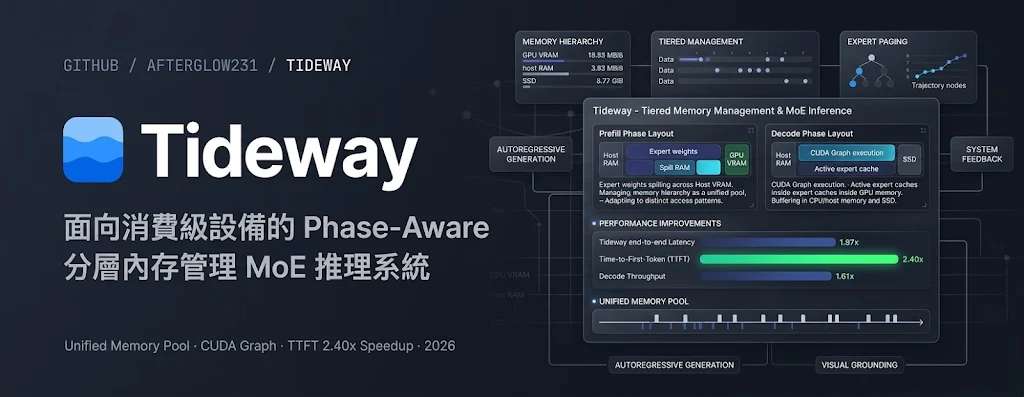
模型裝得下,回覆仍可能卡在搬運。Tideway 是面向個人電腦的推理系統,協調 GPU VRAM、主機 RAM 與 NVMe SSD,處理 MoE 模型權重超出記憶體的問題。在 RTX 5090、32 GB VRAM、48 GiB RAM 下,Qwen3.6-35B-A3B 的 TraceLab 全程加速達 3.14×,相對各設定最快 baseline,也是表內該欄最高值。

MoE 會按輸入選用不同 experts,即負責部分運算的模型組件。Tideway 改善的是組件搬運與執行安排,模型本身仍須另行提供。項目文件批評各層獨立 cache 加固定配置的做法:讀取長提示時反覆從 SSD 載入權重,逐字生成時又因缺少 expert,退回開銷較高的逐步執行。

項目測試涵蓋 Qwen3.6、Gemma4 及 DeepSeek-V4-Flash 的指定版本,並與 FreeToken、llama.cpp 等引擎比較。不過,提供的表格只有欄名,缺少各項結果,無法核對摘要所報加速幅度及各條件下的最快基準。

下面為 OpenMausBot + Remotion 根據原片做的中文版

Tideway 把 VRAM 與 RAM 當成由 SSD 支援的統一空間,先回收跨層重複副本。GPU 逐出某個 expert 時,系統也會利用閒置 PCIe 通道,選擇性將唯一副本送回 RAM。這樣安排是為了容納更多不同 experts,減少日後重新讀取 SSD;代價是系統必須持續管理組件位置與搬運時機。

讀取提示的 prefill 階段與逐字生成的 decode 階段,存取模式並不相同,因此系統會在兩者交界切換配置。prefill 會借用 VRAM 輪流載入權重,同時固定 RAM 內可重用的 experts,防止掃描整個模型時把它們逐出。進入 decode 後,系統解除固定,並把借用空間改回地址固定的 expert cache,讓生成階段按需要補入組件。

只減少 SSD 讀取仍不足以消除 GPU 等待。Tideway 在計算當前層時,同步傳送下一層權重;decode 則使用分段 CUDA Graphs,即重播預先記錄的 GPU 運算步驟。主機把缺少的 experts 搬入固定位置,再接續重播下一段,毋須因組件位置變動而重新記錄整套運算。

TraceLab 的多輪編程智能體測試,更接近反覆讀提示、生成答案的工作流。以下均使用 RTX 5090 的 32 GB VRAM,數字是相對各設定最快 baseline 的全程加速:Qwen3.6-35B-A3B 使用 BF16,權重為 67 GiB;RAM 為 64 GiB 時達 1.20×,48 GiB 時達 3.14×,32 GiB 時達 2.04×。因此,加速幅度並非隨 RAM 減少而持續增加,不能把最高值套用到所有桌面配置。

同一測試中的 Gemma4-26B-A4B 使用 BF16,權重為 48 GiB;RAM 為 48 GiB 時達 1.51×,32 GiB 時達 1.47×,16 GiB 時達 2.66×。DeepSeek-V4-Flash 使用 FP4,權重為 155 GiB;RAM 為 128 GiB 時達 1.31×,96 GiB 時達 1.64×,64 GiB 時達 1.69×。這些模型是測試對象,各自的權重大小與格式不同,不能把差距單純歸因於模型名稱或 RAM 容量。

比較組包括 FreeToken、llama.cpp、SSD-LLaMA 與 FlashMoE;後兩者是已發表機制的獨立實作。長提示令大量 experts 輪流被讀取、或生成時所需組件仍在 SSD,搬運就仍會直接拖慢回覆,Tideway 只能減輕這個瓶頸。資料未列明 NVMe SSD 型號、固定形狀測試的輸入輸出長度,以及各設定的絕對延遲,因此倍數不能直接換成使用者要等多少秒。

準備本地編程智能體測試的團隊,需要 Linux、Python 3.12+、NVIDIA GPU、CUDA 13 toolkit 與 GCC,並另備模型檔案及 NVMe SSD。安裝項目後還要編譯 backend,再於載入 FreeToken 前呼叫 tideway.activate_backend();隨附整合基於 FreeToken 0.1.2,提供資料未交代發布節奏或 issue 活躍度。下一步應用自己的提示與多輪任務測量完整等待時間,分開記錄開始回覆前及逐字生成時的延遲,再決定記憶體配置。

GitHub

Categories: 開源, 模型, Qwen, DeepSeek, Gemini, LLaMa, 推理引擎

Code World Model 2.0:邁向無限可控影片生成

它把場景控制交給 proxy,讓影片模型負責外觀與光照,並以連續串流處理長時間畫面。

Code World Model 2.0 overview: diverse proxies, action-driven branching, adaptive granularity, orbit views, subject and

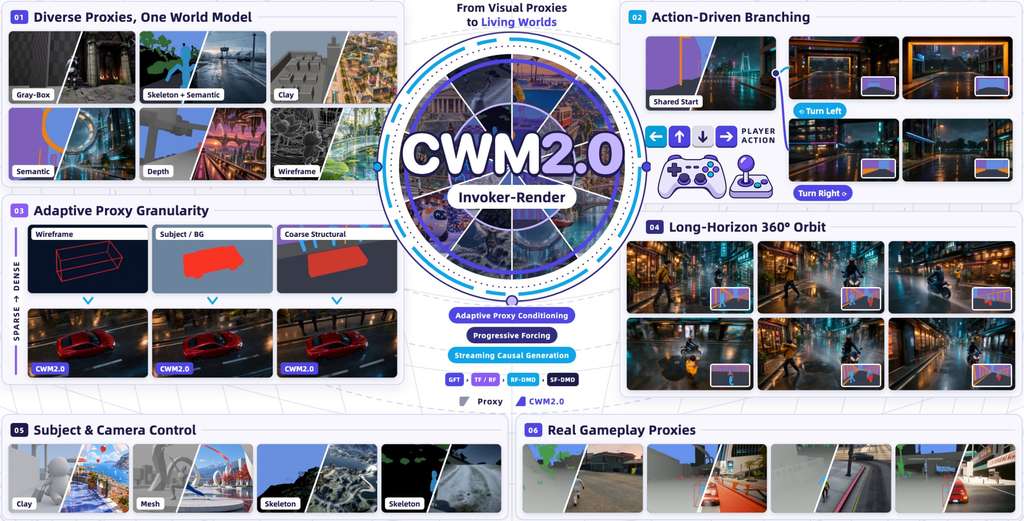
畫面可以長時間生成,控制卻不必鎖死在單一格式。Code World Model 2.0 是一套世界模型影片生成系統,實際由 Invoker-Render 負責把結構代理轉成影片。在 140 個 held-out rollouts 的比較中,Invoker-Render 整體 Elo 為 1343.2,高於 SolarRenderer (Causal) 的 1245.3、StreamRender-H3 的 1051.9,以及 Streaming CWM 的 359.6;四個評審項目均排首位。

它處理的不是單純文字轉影片,而是「誰控制世界、誰負責畫面」的分工。上游引擎維持世界狀態,輸出 structural proxy;Invoker-Render 再根據 proxy、參考首幀和文字生成材質與光照。30 分鐘賽車示範以粗略 racing proxy 連續生成,中途沒有剪接或重設,但這個示範使用了預設服務沒有開啟的 reference-guided quality policy,因此不能直接當成一般部署的吞吐量保證。

proxy 可以理解成影片的結構草稿:它指定鏡頭路線、場景佈局和物件動作,卻不負責最後的外觀。同一模型可在執行時接受 semantic maps、sparse 3D boxes、subject masks、shaded geometry 或 boxes with skeletons。固定首幀和場景後,只改 proxy 就能改鏡頭路線;固定首幀和鏡頭路線後,改 proxy 就能改場內物件動作,這種拆分比每次重新生成整段影片更容易追查控制是否真正生效。

研究展示並非只把幾段漂亮片段放在一起。Camera control 固定首幀和場景,只替換鏡頭 proxy,藉此排除外觀或場景變化造成的誤判;world dynamics 則固定鏡頭,只改變交通、行人或橋樑動作。Proxy correspondence 會把 proxy 與輸出逐幀疊加,觀眾可調透明度核對物件位置,直接檢查模型是否跟隨結構,而不只依賴主觀畫質。

串流版本建基於 MiniMax-H3、SGLang 和 SGLang-Omni,並以 Progressive Forcing 分階段訓練,每個 chunk 在生成時執行 4 步。每個 chunk 只讀取固定的 appearance anchor 和有限範圍的近期生成記錄;只要持續收到 proxy 畫幀,同一個 session 就能繼續生成。這正是它和一次生成固定長度影片的做法不同之處,但也代表長時間一致性仍取決於持續輸入的 proxy 及狀態管理。

Code World Model 2.0 部署門檻不低:需要 Linux、Python 3.11 或 3.12、NVIDIA CUDA,預設 production 設定在單一節點使用 8 個 GPU。模型權重放在 Hugging Face 的 inclusionAI/invoker-render-1.0,儲存庫本身沒有附權重、prepared bundle、獨立 lockfile 或個別 checkpoint 的 artifact.json,使用者要按匹配的訓練設定、encoder checkpoint、generator weights 和 prompt 組合資產。檔案推理亦要求首幀為 1344×768 RGB,proxy 影片為 24 FPS,幀數符合 17*N+5 且至少 39 幀;完成後才會輸出 video.mp4 和 inference.json。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 世界模型, 模型訓練, Qwen, Google, NVIDIA, Video, 工具, 3D, Linux, Python, 庫, 蘋果, MiniMax

ALIVE:讓串流影片模型追蹤事件並主動求證

ALIVE 把持續觀看影片的模型推向多輪互動:能等待事件發生、跟進改變中的指示,也會在證據不足時請用戶補充。

ALIVE

等事件出現才回應,線索不足時先問清楚,ALIVE 想補上串流影片模型欠缺的互動能力。它是一個串流影片模型,處理持續影像中的事件監察、多項任務協調和回饋索取;在四個公開基準及 FSI-Bench 上,項目文件稱它在比較模型中取得最高整體分數,但未列出分數或比較名單,暫時難以判斷領先幅度。

例如,用戶要求看到某物件時才通知,模型要持續觀察,而不是只回答當下畫面。FSI-Bench 有 1,235 個 feedback-seeking examples,測試情境資料不足時,模型能否找出缺少的前提、索取回饋,再完成任務。這個測試把「問得對」與「最後做完」放在同一流程檢查,避免只因模型頻繁追問,就被當成善於互動。

ALIVE 的三種互動能力各自對應不同工作:Proactive Monitoring 等指定事件出現才回應;Streaming Task Coordination 在多項請求並行時,按新指示更新任務;Feedback-Seeking Interaction 則在畫面不足以判斷時,請用戶澄清、採取具體行動,或同意繼續監察。串流影片模型通常把請求分開處理,ALIVE 嘗試把它們放進同一段持續對話,代價是判斷錯誤會累積在多輪流程中,而不只影響一個答案。

訓練分兩階段,目的在於分開教模型「何時回應」和「如何在多輪互動中取捨」。第一階段的 contrastive supervised fine-tuning 用對照例子教模型因應證據和用戶要求選擇回應或保持沉默;第二階段以 reinforcement learning 調整後續決策。其 Behavior-Aligned Credit Assignment(BACA)結合整段互動與局部表現的評分,讓模型不只看最後答案,也能修正中途的回應、任務選擇和沉默時機。

ALIVE-SFT-288K 有 288,436 個 interaction examples 訓練資料,供 supervised fine-tuning 使用;ALIVE-RL-3K 有 3,523 個 interaction examples,供 reinforcement learning 使用。這些規模說明模型經過大量互動例子訓練,但不能單憑樣本數推斷資料涵蓋範圍或答案可靠度;項目文件目前把訓練資料列為未完成公開項目。

要測試本機瀏覽器示範,需要 Linux、Python 3.12 和兩張 GPU:一張執行 ALIVE,另一張供語音辨識及語音合成共用。模型 checkpoint 是 ALIVE-Team/ALIVE(ALIVE-8B);示範另用 Qwen/Qwen3-ASR-1.7B 辨認語音,以及 Qwen/Qwen3-TTS-12Hz-1.7B-CustomVoice 合成語音。啟動後,項目文件指示在瀏覽器開啟 https://localhost:8090;這是本機示範所需的環境,不等於已提供可直接接入現有服務的部署方案。

兩張 GPU 的門檻不低,示範又同時依賴 ALIVE、ASR 和 TTS,任何一環未能正常運作都會妨礙語音互動測試。公開 benchmark 的逐項分數、比較模型名單和測試設定尚未列明,benchmark and evaluation code 亦仍待發布;因此團隊可以先檢查示範是否符合工作流程,但未宜只憑整體排名決定模型選型。

需要監察長時間影片、同時跟進數項指示,或在視線受阻時向操作員索取新畫面的團隊,會較直接感受到 ALIVE 的設計差異。目前有 ALIVE-8B checkpoint 和本機 web inference 示範,但未交代訓練硬件與時長,資料集和 FSI-Bench 連結亦標示為即將推出。下一步可先按指定雙 GPU 環境跑示範,再等逐項評測與資料公開後核對它在目標情境中的表現。

項目主頁 · GitHub · 模型

Categories: 開源, 北京大學, 清華大學, 字節跳動, 文字轉語音, AI productions, 模型, 模型訓練, Qwen, Video, Image, Linux, Python, 語音, Dataset 數據集, 強化學習

AURA 2.0:看影片時模型會自行判斷何時開口和行動

AURA 2.0 持續接收鏡頭畫面,能主動回應、呼叫工具並指向畫面物件。四項公開基準的結果領先多個比較模型。

AURA 2.0 logo

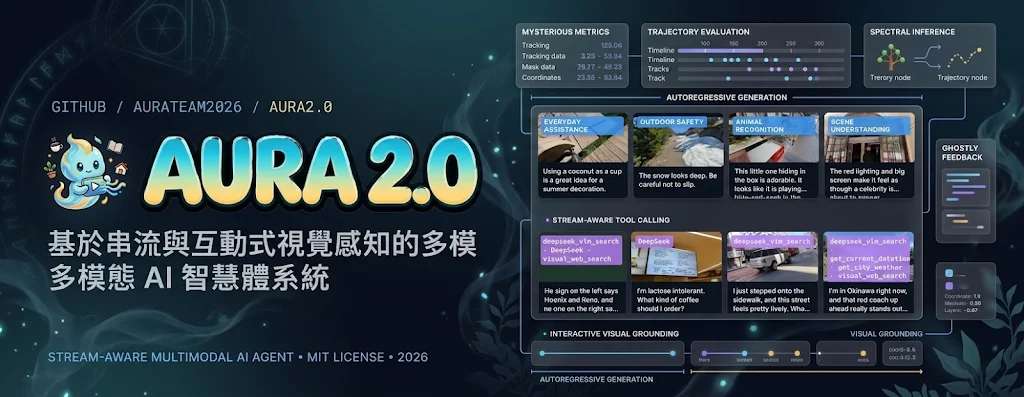
鏡頭一直開着,模型不必等人提問才回應。AURA 2.0 是一套即時視訊對話模型與示範工具,能結合連續畫面和對話記錄,判斷是否開口、何時回答,再以串流語音回應。它也能選用工具,並把回答連到畫面中的具體物件。

在 ProactiveVideoQA 四個數據集的平均分(ω = 0.5)中,AURA 2.0 (9B) 得 50.75,高於 MOSS-VL-Realtime (11B) 的 47.18;同一評測中,JoyAI-VL-Interaction (8B) 得 36.95。這個差距反映模型不只要答對,還要判斷何時介入;但分數只代表該基準的設定,不能直接當成日常對話品質保證。

瀏覽器示範把互動放在視訊通話流程內:使用者按住 Hold to talk 說話,放開後送出,也可打字或在畫面上畫記號。收到第一個視訊封包後才可輸入文字問題。模型用 Stream-Aware Tool Calling 按需求選工具和參數,取得執行結果後再作答;Interactive Visual Grounding 則把回答連回特定畫面物件,減少「你說的是哪一個」的含糊。

PhoStream 的 Overall 總分中,AURA 2.0 得 65.69,MOSS-VL-Realtime 得 43.88,JoyAI-VL-Interaction 得 33.40;VideoLLM-Online 得 12.34,MMDuet2 得 4.96。這些結果來自技術報告所列評測,不是同一套綜合分數:IPIBench、StreamArena 和 ProactiveVideoQA 各按指定方式平均,PhoStream 則採用報告的 Overall。研究訓練時亦特別處理沉默與回應標記數量不平衡,對兩類標記使用 focal loss,其餘受監督 token 使用交叉熵,目的是避免模型只因常見標記較多而偏向沉默或回應。

要試用示範,需在 Linux x86_64 伺服器部署;開發環境為 Ubuntu 22.04,安裝環境使用 Python 3.12、固定版本的 vLLM 0.33 wheel,以及隨附的 vLLM-Omni。項目文件驗證的是兩張 80 GB 加速器:一張跑 AURA,另一張共用作語音辨識和語音生成;依賴和模型權重至少要預留 50 GB 磁碟空間。啟動後可在本機瀏覽器開啟 gateway,手提電腦可經 SSH tunnel 連線;亦提供 Docker 部署方式,但沒有預建的公開映像。

硬件門檻是單卡配置需約 70 GB 可用記憶體。兩卡配置預設為 AURA 預留約 90%,語音辨識和生成共用的另一張卡預留約 38%;單卡配置預留 88%。即使改用 AURA 2.0 BF8,記憶體預留比例也不會自動下降,因此不能只看量化權重便假設能放進較細的硬件。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, 華為, AI productions, 模型, 模型訓練, Qwen, DeepSeek, API, Video, Image, 工具, Linux, Python, 語音, 安全, Dataset 數據集

Page 1 of 194
1 2 3 … 194