Building Rome 單張相片重建完整 3D 場景

只用一張相片,Building Rome 便嘗試補全鏡頭外的建築與室內結構,生成可探索的 3D 場景網格。連看不見的空間也能生成。

Og image

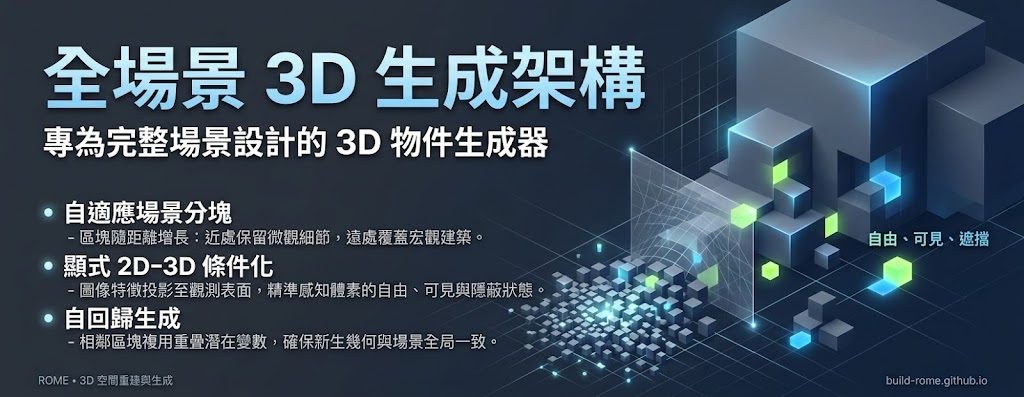
只得一張相片,Building Rome 便嘗試補全鏡頭未拍到的空間,生成室內、戶外及大型環境的完整 3D scene mesh。這個單影像 3D 場景重建項目,處理的是照片只提供單一視角、遠近物件細節不一致,以及隱藏幾何無法直接觀察的問題。

方法把場景切成會隨距離變化的 adaptive chunks:近處使用較細區塊保留細節,遠處則用較大區塊涵蓋建築。影像特徵會投射到已觀察到的表面,而每個 voxel 亦會標示空置、可見或隱藏狀態;生成鄰近區塊時重用重疊 latent,令新加入的幾何結構較能保持連貫。

讀者可以透過互動檢視重建結果,透過拖曳旋轉、滾輪縮放及 WASD、Q、E 移動,亦可選取兩點量度距離。網頁展示用 mesh 為方便瀏覽而簡化至約 1.5M faces,論文圖像及影片則採用完整解析度,因此兩者的視覺細節不應直接視為相同。

  • 單張相片重建室內、戶外及大型場景
  • 以 adaptive chunks 處理不同距離的細節
  • 透過 2D&3D conditioning 推斷可見與隱藏幾何
  • 以 autoregressive generation 延續相鄰區塊的一致性
  • Code 標示為即將提供,現時可先透過互動網頁查看結果

項目由 Applied Intuition 聯同 Purdue University、UIUC 及 UC Berkeley 研究人員完成,並以 World Tracing、GenRecon、VolFill 及 Lyra 2.0 等方法作比較。對需要由照片建立可探索環境、進行空間分析或製作 3D 內容的人,這種由單一視角推算完整場景的做法提供了另一條工作流程,但隱藏區域屬於模型生成,不能當作相片直接觀察所得的精確測量。
項目主頁 · 項目

Categories: 開源, AI productions, 模型, 視覺模型, Video, Image, 3D, Anthropic

DistScene 從圖片生成可供導航模擬的 3D 場景

生成物件之外,DistScene 也建立周邊環境,讓圖片轉成的 3D 場景可直接匯入導航模擬器。

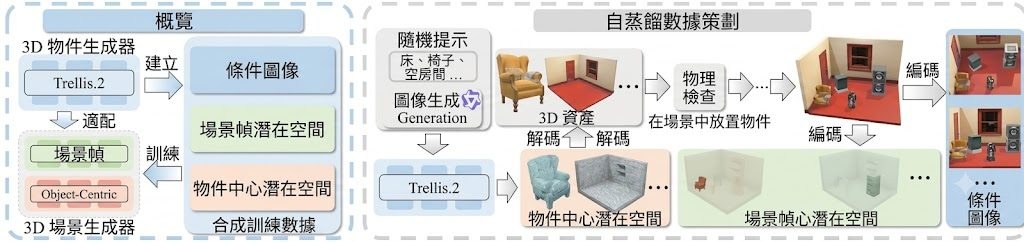
DistScene self-distilled data curation: Trellis.2 generates objects and environments, physics checks guide scene assembly, and rendering provides conditioning images.

把圖片轉成可供導航模擬的 3D 空間,需要同時建立物件與周邊環境。DistScene 這個 3D 場景生成研究項目,讓兩者在同一場景中生成,再逐件細化物件。

其 Object-to-Scene Distillation 方法以 Trellis.2 生成訓練素材:先由視覺語言模型(Vision-Language Model,VLM)描述物件與環境,再生成輸入圖片及 3D 資產,組合時加入物理檢查。

生成流程採用 Unified Scene Representation,先在共用 scene frame 內完成 sparse structure generation 與 geometry-latent generation,再把物件轉到 local voxel support,結合場景資訊細化後放回原位。

  • 同時生成環境及可分開處理的物件。
  • 場景可直接匯入導航模擬器。
  • 互動預覽經壓縮,約為原始結果的 10%。

導航模擬是已展示的用途,但程式碼、Checkpoint 及 Dataset 仍標示即將公開;目前未提供量化性能或對比結果,重現效果仍有待驗證。

項目主頁

Categories: 模型, 視覺模型, 多模態模型, 視頻模型, 模型訓練, Video, Image, 3D, Dataset 數據集

GUI-HARVEST:不改模型,讓 GUI Agent 自動進化

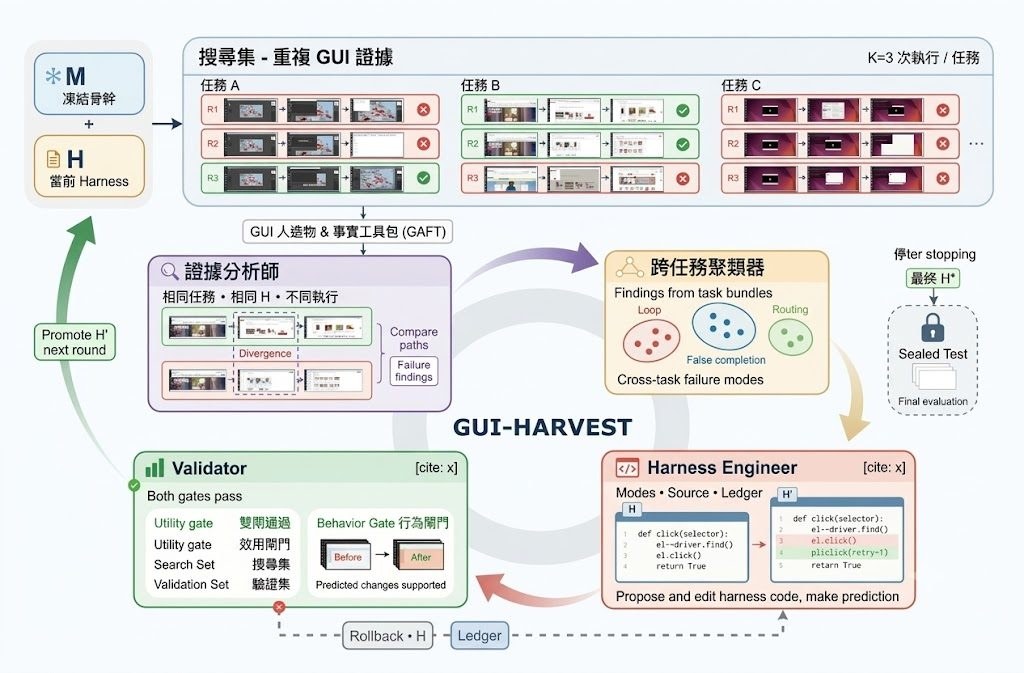
GUI-HARVEST 讓 GUI agent 從重複操作失敗中修改執行 harness,在不更新模型權重下提升任務表現。

GUI-HARVEST overview

當 GUI agent 反覆在相似操作中失敗,問題未必出在模型權重,也可能是提示詞、記憶、工具介面或復原流程。GUI-HARVEST 屬於自動化 harness 演化工具,會讀取 GUI rollout,找出跨任務重複出現的行為故障,再把修正寫回 harness 原始碼。

它固定 GUI-capable model、整理失敗證據,Harness Engineer 提出帶有明確預測的修改,Validator 再按分數和行為閘門決定保留或回滾。

和 LoRA 或重新訓練模型相比,GUI-HARVEST 不需要更新模型權重,代價是改進依賴可執行 harness 的品質,以及 Search、Validation 和 Test 分割是否設計得可靠。每個候選修改都要同時滿足 ΔSearch ≥ 0、ΔValidation ≥ 0、至少一項提升、行為預測通過,以及 L0/L1 檢查;Test suite 會在優化停止後才開放一次。

測試需要另外安裝 OSWorld 和 seed harness,例如 Agent S3,再以固定 seed 按 domain 分層建立 80 個 Search、80 個 Validation 和 201 個 sealed Test 任務。項目適合研究 GUI agents、維護長流程自動化工具,或需要比較不同 backbone harness 的團隊;OSWorld-Verified 結果顯示,六個 backbone 和三種步數預算的比較中,GUI-HARVEST 均取得最高分,Qwen3-VL-32B 在 15 steps 提升 12.33 個百分點,Gemini 3.1 Pro 在 100 steps 達到 79.14%。

  • 凍結模型權重,集中改善可執行 harness
  • 從 screenshots 和 action traces 提取重複故障
  • 以 Search、Validation 和 sealed Test 控制改動風險
  • 支援固定不同模型與步數預算作比較

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, 提示詞, 工具, Dataset 數據集

HuatuoGPT-3 以單階段強化學習調整醫療語言模型

醫療模型通常要先經專門監督微調,再進行強化學習;HuatuoGPT-3 嘗試省去前一步,直接以 OnePO 適應醫療任務。

OnePO framework

想把語言模型調整到醫療問答,HuatuoGPT-3 嘗試減少一個訓練階段:它是以 One-stage Policy Optimization(OnePO)訓練的醫療大型語言模型系列,目標是在不先做領域監督微調(SFT)的情況下,透過單階段強化學習適應醫療任務。

OnePO 會先借助教師模型的回答提供指引,再按模型學習進度調整訓練方式。Adaptive Objective Evolution 協助模型學習原本較少選出的教師答案 token;當模型自己的回答所得 reward 已追上或超越教師,Teacher Retirement 便停止教師指引。這做法省去預先進行醫療 SFT 的要求,但訓練仍依賴教師回答、reward 設計和任務資料的質素。

模型系列包括 HuatuoGPT-3-9B 和 HuatuoGPT-3-27B,分別以 Qwen3.5-9B 和 Qwen3.8-27B 為基底;另有以 Qwen3-8B 為基底的 HuatuoGPT-3-Grader-8B。HealthBench Professional 分數方面,9B 版為 68.3,27B 版為 71.4;倉庫沒有列出 Grader 的同項分數,因此不能據此比較評分器表現。

  • 20,338 項 OnePO-Medical-20K 醫療強化學習任務,涵蓋選擇題和開放式回答。
  • 選擇題以答案是否完全吻合驗證,開放式回答則按多項臨床準則評分。
  • 提供模型、訓練程式碼、資料集及 rubric grader,適合研究醫療模型訓練的團隊檢視或重現流程。

模型可按 Qwen3.5 的方式使用,並透過 vLLM 或 SGLang 部署;訓練則需先按文件準備 GPU 環境。對醫療服務團隊而言,這些模型可作研究與評估起點,但倉庫列出的基準分數本身不足以證明模型適合臨床決策,仍需按目標用途進行安全性、準確度及臨床評估。

GitHub

Categories: 開源, 模型, 模型訓練, Qwen, Medical醫學, 庫, 安全

CIA-minimal-repro:與思維鏈一致性改進模型訓練

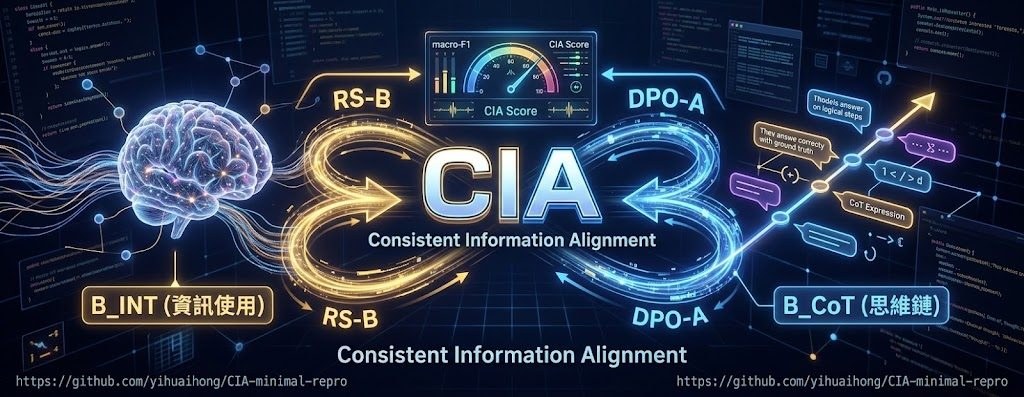
CIA 將模型是否真正使用關鍵資訊,與 CoT 是否說出相關內容分開量度,再用 RS-B 和 DPO-A 改善兩者的一致性。

Repository image for yihuaihong/CIA-minimal-repro

當模型答對問題,卻未必真正用到提示中的關鍵資訊,CIA 以可驗證的方式拆開這個差異。這個 GitHub 項目屬於模型訓練及評估程式碼,處理模型內部資訊使用(B_INT)與 Chain of Thought(B_CoT)表述是否一致的問題,並以 macro-F1 定義 CIA 分數。

RS-B 和 DPO-A 使用同一批資料起步:基礎模型為每個提示取樣 16 個回答,再按內部使用資訊、CoT 表述及答案正確性標記。RS-B 保留 B_INT 與 B_CoT 一致的回答進行 SFT,即使答案未必正確;DPO-A 則按正確性加一致性排序,將每題排名最高及最低的回答配對作 DPO,取捨更偏向同時追求正確和忠實表述。

評估涵蓋 TwoHop、Hint 和 Mult 三項任務。TwoHop 以線性 probe 讀取隱藏狀態,Hint 使用 Qwen2.5-32B-Instruct 判斷 CoT 是否承認提示,Mult 則以 causal corruption test 檢查答案會否跟隨被修改的中間乘積;這些方法比單看最終答案更能暴露模型是否真正依賴關鍵步驟。

  • 可重現範圍:提供 RS-B、DPO-A、訓練流程及三項任務的評估入口。
  • 限制:儲存庫只有程式碼,不包含資料、模型權重、probe 權重或實驗結果。
  • 硬件要求:預設以 2 張 GPU 配合 Accelerate 和 DeepSpeed ZeRO-3,原始實驗使用 80 GB A100、H100 及 H200。
  • 檢查方式:TwoHop 每 15 步儲存 checkpoint 並選驗證集峰值,Hint 和 Mult 則只保留最終模型。

研究人員可用它重跑訓練及檢查指標定義,已有 Hugging Face Open R1 訓練環境的團隊亦較容易接入;但缺少資料與權重,不能直接下載後重現結果。項目更適合作為研究管線的精簡骨架,而非開箱即用的完整模型。

GitHub

Categories: 開源, 模型, 模型訓練, Qwen, DeepSeek, 框架, 庫, 深度學習

Meta 開源 Muse Gadgets SDK:把 ESP32 與樹莓派變成 AI 配件

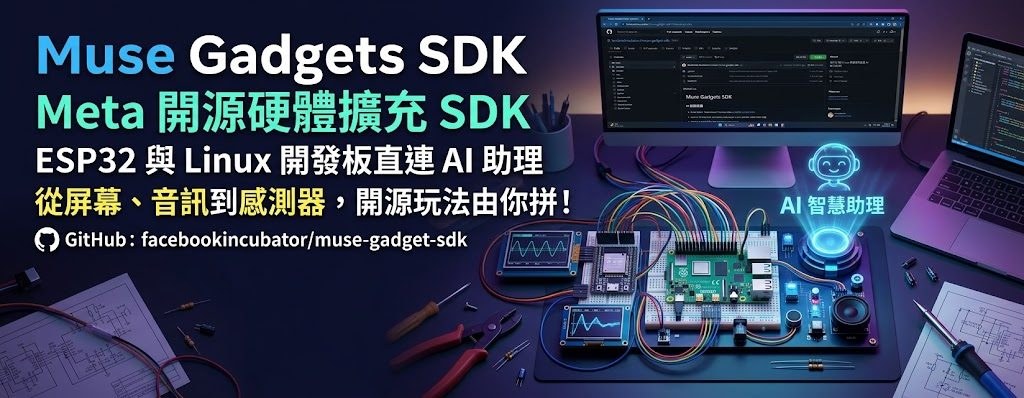
Meta 把 Muse 的硬體擴充 SDK 放到 GitHub,讓你手邊的 ESP32 與 Linux 開發板直接接駁 AI 助理。從屏幕、音訊到感測器,開源玩法交給社群自己拼。

Muse gadgets: a Waveshare round AMOLED, an M5Stack StickS3, Muse Home Link, a Raspberry Pi and a Seeed reTerminal e-ink

想讓家裏的 ESP32 或樹莓派直接跟 AI 助理對話嗎?Meta 旗下 facebookincubator 開源的 Muse Gadgets SDK,正是針對這種「自製 AI 配件」場景而設的開發工具包。項目分為 ESP32 與 Linux 兩條主線,分別對應 MicroPython 級別的微控制器,以及樹莓派或一般 Linux 單板電腦,開發者可以按自己手邊的硬件選擇對應 SDK。

每塊板配對 Muse 應用前需要先在 gadgets.muse.ai 申請 SDK token,並開啟 App 內的 Developer mode,掃描「MuseGadget」前綴的裝置即可連線。ESP32 路線主打屏幕顯示、I/O 音訊與各類感測器,Linux 路線則偏向讓 Muse 處理 Home Assistant 自動化或系統管理指令,等於把語音助理變成 Home Lab 的遙控器。

項目定位屬於「工具+框架」混合體,核心價值是降低自製硬件的門檻,但要求開發者有一定焊接與刷機經驗,因為 README 已經明言副作用包括「bricked boards」、保養失效甚至電壓跌落。相對於坊間封閉式智能家居配件,它勝在完全開源並允許自定義指令,但又需要自備 token 與相容硬件,部署成本不低。

硬件玩家、Home Assistant 玩家,以及想用 AI 助理串連感測器或自製機械按鈕的開發者,最容易從中受惠。每個子目錄都附上 README.md 與供 AI 編程助手如 Muse Code 使用的 AGENTS.md,社群則集中在 Discord 交流改機心得。

項目重點摘要

  • 支援 ESP32 與 Linux(樹莓派)兩條開發路線,各自獨立 SDK
  • 配對 Muse App 需先申請 SDK token 並開啟 Developer mode
  • 涵蓋顯示、音訊、感測器、Home Assistant 自動化等多種擴充方向
  • 程式以 Apache 2.0 開源,第三方組件如 minimp3 保留上游 CC0-1.0 許可
  • 社群交流集中在 Discord,文件內附 AGENTS.md 方便 AI 編程助手介入

項目主頁 · GitHub

Categories: 開源, Agentic, API, Audio, 框架, Discord, Linux, 編程, 語音, Meta

RealtimeWAM 讓世界動作模型走向即時生成

LightX2V 的 RealtimeWAM 以單步生成降低延遲,嘗試保留多步模型的表現,讓機械人動作反應更接近即時。

Og image

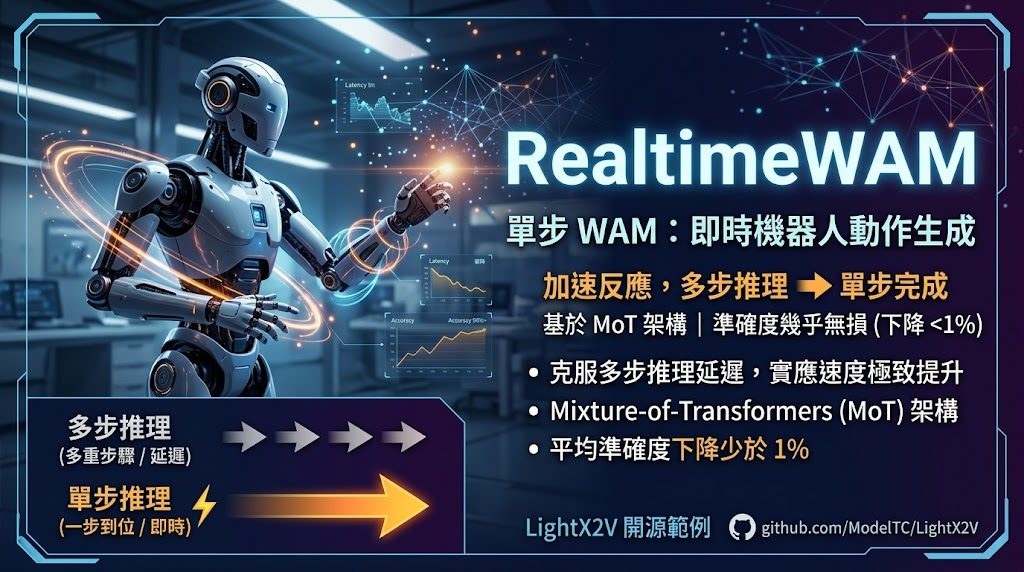
機械人需要根據畫面快速產生下一個動作時,多步推理帶來的延遲會直接影響反應速度。LightX2V 的 RealtimeWAM 範例針對這個取捨,提供面向即時推理的 World Action Models (WAM) 方法,將動作生成壓縮至單步完成。

RealtimeWAM 建立在 Mixture-of-Transformers (MoT) 架構的 WAM 之上,主張在減少推理步驟的同時,盡量維持原有模型的準確度。項目 README 將它描述為首個單步 WAM,並指出相較多步版本,跨多個基準測試的平均準確度下降少於 1%。

項目列出的測試包括 RoboTwin 2.0 和 LIBERO,涵蓋機械人操作相關場景。這代表它較適合需要低延遲動作決策的研究者、機械人控制工作流,以及希望在既有 MoT-based WAM 架構上探索即時生成的開發者;不過,實際效果仍會受模型、硬件和測試任務影響。

  • 單步生成,降低多步推理造成的延遲
  • 兼容以 Mixture-of-Transformers 為基礎的 WAM 架構
  • README 聲稱平均準確度下降少於 1%
  • 提供 RoboTwin 2.0 和 LIBERO 等評估參考
  • 以 LightX2V 框架形式呈現即時 WAM 範例

項目主頁

Categories: 開源, Agentic, MCP, 模型, 世界模型, World-Action Model, Robotic, 框架, 安全, Skill 技能

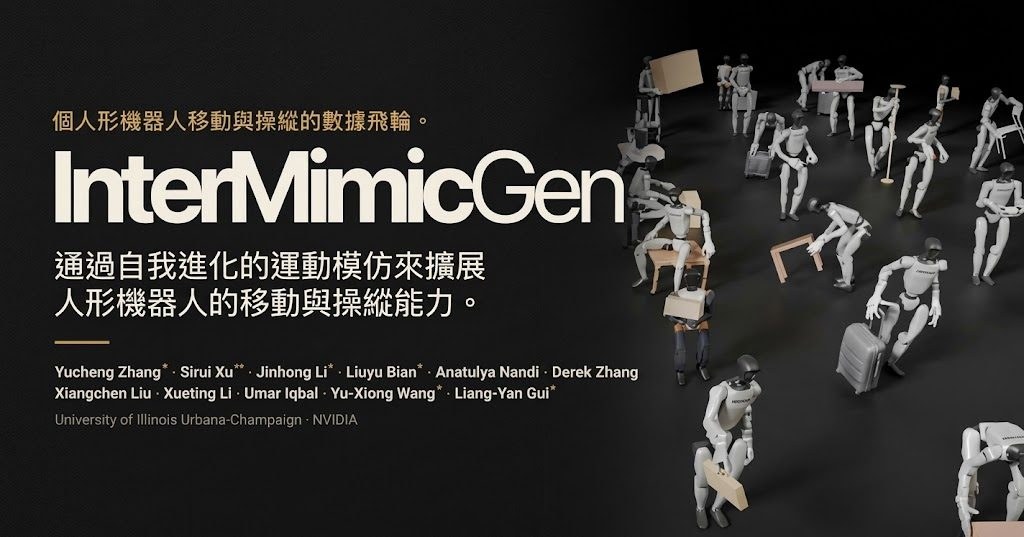
InterMimicGen 讓一段示範變成多種機械人動作

InterMimicGen 把人類互動示範轉化成不同人形機械人的動作,並透過實體執行持續擴充數據。

Og image

一段人類與物件互動的示範,經過 InterMimicGen 可以轉化成多種人形機械人的行走、抓取和操作動作。這個研究項目針對不同機械人身體結構難以直接套用同一動作的問題,連接動作重定向、追蹤、演化和實體部署流程。

系統結合 MimicGen 的動作擴展方式與 InterMimic 的物理落地能力,先把示範調整至不同物件和機械人配置,再由真實機械人執行。每次成功完成的動作都會成為新數據,支援下一輪生成,形成持續增長的數據循環。

• 跨物件重定向,例如行李箱和大型箱子
• 支援 Unitree G1、Dexmate Vega、Booster K1 等平台
• 涵蓋雙手操作、抓取及不同手部配置
• 透過多輪局部修改,逐步擴大動作範圍

研究展示了 Unitree G1 配合 Inspire hands、橡膠手,以及 Dex3 等組合的實體執行案例,也測試大型梳化、三腳架和球拍等不同物件。內容未有提供統一的量化性能指標,成果主要以跨平台動作轉移和連續實體執行作展示。

這個項目較適合研究人形機械人模仿學習、動作重定向和資料生成的團隊。它的價值在於減少每個機械人配置都要重新收集示範的需要,但動作是否成功仍取決於機械人的硬件、手部形態和現場環境。

項目主頁 · Paper

Categories: NVIDIA, Robotic

xllm-loop:循環語言模型

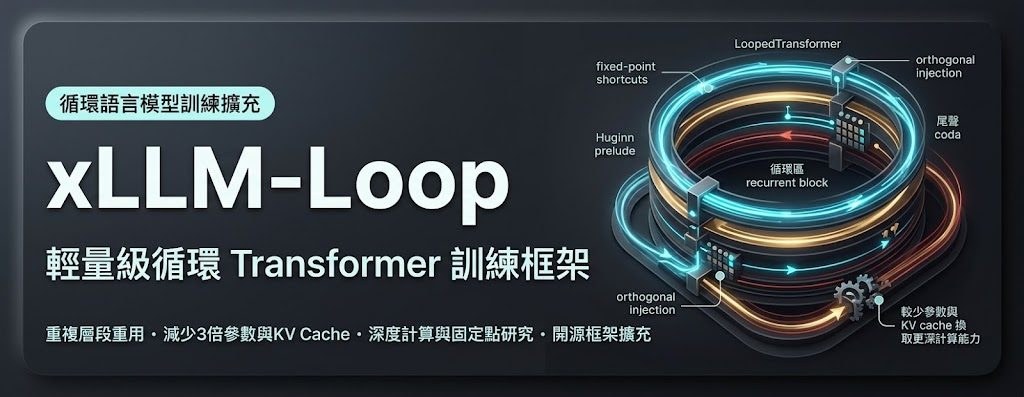
xLLM-Loop 把同一組 Transformer 層重複運算,探索以較少參數和 KV cache 維持語言模型能力。以更少參數換取更大推理深度。

Repository image for ifm-ai/xllm-loop

想用較少模型參數和 KV cache,換取更深的計算能力,xLLM-Loop 提供了一條可直接研究的路線。它屬於開源語言模型訓練框架擴充,處理的是循環語言模型如何重用層、控制深度,以及評估固定點帶來的效率取捨。

LoopedTransformer 會重複執行指定層段,Huginn 則把模型分成 prelude、recurrent block 和 coda,並支援單一或階層式 recurrent state。Part II 進一步研究 fixed-point shortcuts、learned depth prior 和 orthogonal injection,目標是在增加 FLOPs 時維持近乎固定的記憶體需求;相關說法包括較標準 Transformer 少約三倍參數和 KV cache,但不能視為所有任務都能達成的保證。

項目已接入 xLLM,提供兩篇研究工作的 training、evaluation 和 checkpoint 程式碼,並有 49 個 Hugging Face checkpoints。Part I 涵蓋 Dense 和 MoE 共 17 種 recipes、25 個 checkpoints;Part II 涵蓋 depth priors、input-injection variants 和 distilled prefill,共 24 個 checkpoints。

  • 適合研究循環架構、固定點推理和參數效率的模型團隊
  • 可比較固定、抽樣及 learned depth 的訓練方式
  • 支援 LoopedTransformer、Huginn 和 DepthControlledHuginn
  • 需要 PyTorch 2.11、CUDA 12.8、Python 3.12,實驗曾使用 NVIDIA H200

安裝方式沿用 xLLM,但硬件和軟件版本要求偏新,訓練成本亦不低,論文實驗是在 NVIDIA H200 上完成。對想在本地直接使用成熟聊天模型的人,它不是即裝即用的產品;對需要重現研究、載入 checkpoints 或改造訓練流程的團隊,程式碼、評估及 checkpoint 配套就更有價值。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 模型訓練, NVIDIA, 框架, Python

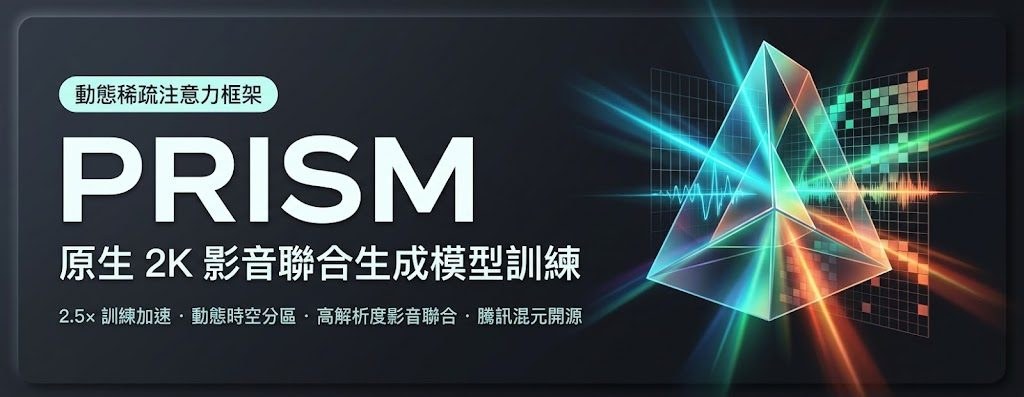
Prism 令 2K 影音生成訓練加速 2.5 倍

Prism 將影片畫面與聲音互動納入稀疏注意力,令原生 2K 影音生成模型訓練更快,並兼顧生成質素。

model architecture

高解像度影音生成最難處理的地方,是畫面 token 大增後,Full Attention 需要付出平方級計算成本,聲音與畫面之間的有效互動亦容易被大量冗餘資訊沖淡。Prism 屬於 Dynamic Sparse Attention 框架,專門處理原生 2K Joint Video-Audio Generation Model Training,目標是減少訓練成本而不犧牲影音同步與細節。

Prism 將影片 token 按時空位置整理成 macro-zones,再利用影片特徵的 channel variance,以及 audio-to-video cross-attention 的 feature norm,判斷每個區域的畫面變化和聲音影響程度。變化較快或影音耦合較強的位置會採用更細的 block 分割,並透過 hybrid block selection 為不同 query 動態決定稀疏範圍,令每個 block 保留較一致的語義內容。

[Fudan&Tencent Hunyuan] Prism: Dynamic Sparse Attention for Native 2K Joint Video-Audio Training

同 Full Attention 相比,Prism 不再對所有 token 進行密集互相關注;同時,它亦不是單純套用只為推理加速而設的稀疏注意力。這個取捨針對聯合影音資料的結構作出調整,代價是訓練流程需要額外計算區域資訊和動態選擇,實作複雜度會高於標準注意力。

項目提供 Project Page、Hugging Face 模型和示範影片,可先透過合成結果、模型比較、消融研究及解析度擴展示範理解效果。提供的資料未列出完整本地安裝指令或硬件要求,因此暫時較適合研究團隊按論文與模型資源自行整理環境,而不是即時套用到一般影音工具。

  • 訓練速度較 Full Attention 提升 2.5 倍
  • 生成質素據報超越 Full Attention
  • 同時考慮視覺變化與 audio-visual coupling
  • 面向原生 2K 影音生成模型訓練

Prism 對需要訓練高解像度文字轉影片及同步聲音模型的研究團隊較有價值,尤其適合計算資源昂貴、影音互動集中於局部區域的工作。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, AI productions, 模型, 多模態模型, 模型訓練, Google, NVIDIA, Video, Audio, 框架, 工具, 語音

Page 1 of 165
1 2 3 … 165