LightMIS 以輕量化架構推進醫學影像分割

LightMIS以精簡多尺度編碼器取代傳統逐階解碼器,嘗試在減少模型參數與運算量的同時,維持醫學影像分割表現。

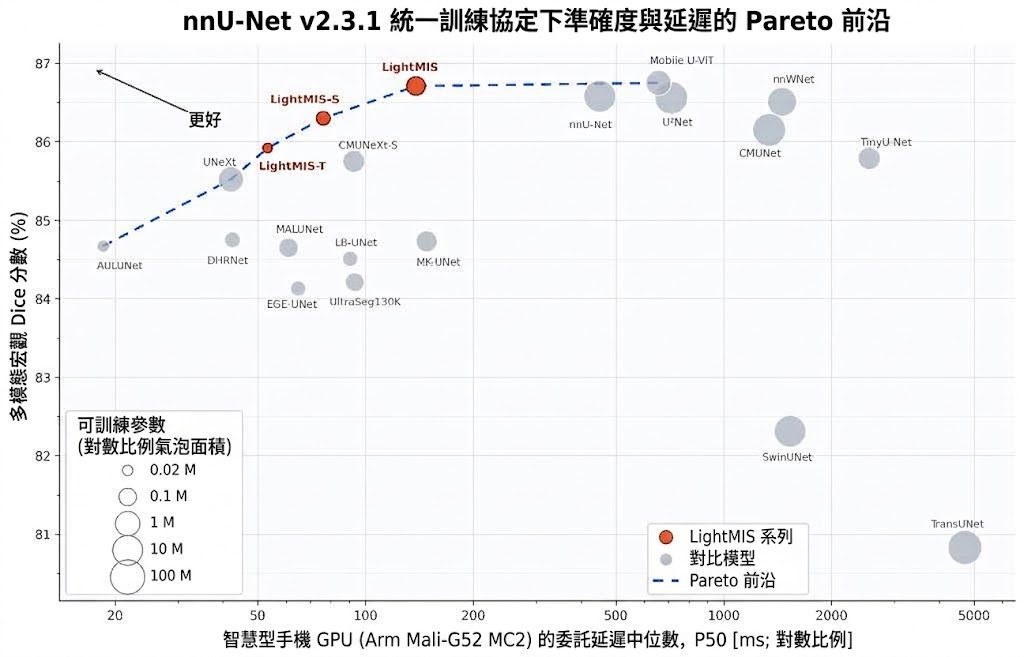
LightMIS accuracy–latency Pareto front

在手機 GPU 上執行醫學影像分割,模型大小與處理速度都會影響部署選擇。LightMIS 是一款面向 2D 二元醫學影像分割的輕量模型,透過精簡多尺度編碼器和聚合式輸出頭,減少傳統逐階解碼器帶來的重複上採樣及特徵融合運算。

模型在每個空間尺度使用 Adaptive Fusion Cascade(AFC)處理特徵;其中的 Progressive Receptive Fusion(PRF)會暫時擴展通道,配合不同深度卷積感受野及分支間逐步傳遞資訊,補足窄通道特徵的表達能力。編碼器各層輸出再由 Scale-Aligned Projection(SAP)對齊至相同解析度與通道寬度,融合後交由最後一個 AFC refinement,毋須沿用逐層上採樣的解碼結構。

在 nnU-Net v2.3.1 的共同測試流程下,研究以六個資料集、五個影像領域及五折交叉驗證評估模型。LightMIS 的區域重疊指標與明顯更大的 Mobile U-ViT、nnWNet 和 nnU-Net 接近,邊界距離結果亦具競爭力;參數量少 90.58% 至 99.61%,GFLOPs 少 82.54% 至 96.14%。

在配備 Arm Mali-G52 MC2 GPU 的手機上,各版本都達到 100% GPU 算子覆蓋率;LightMIS-T 的委派中位延遲為 53.31 毫秒,LightMIS 為 138.31 毫秒。這些結果適合參考於需要控制模型體積、運算量或手機端推理的研究與開發工作,但不代表所有裝置和醫療場景都會有相同速度或準確度。

要重現測試,需配置 nnU-Net v2.3.1,將 DRIVE、Kvasir-SEG、DSB18、BUSI、ISIC-2017 或 ISIC-2018 等資料集轉成 nnU-Net 格式,再執行 2D 規劃、預處理及五折訓練。儲存庫提供資料轉換腳本和訓練器檔案;文章草稿所據內容未包含完整命令及硬件部署流程,不能據此推斷安裝後即可直接在手機執行。

  • 適用任務: 2D 二元醫學影像分割。
  • 核心做法: AFC 與 PRF強化多尺度特徵,SAP 對齊並聚合編碼器輸出。
  • 主要取捨: 減少參數量與 GFLOPs,並省去傳統逐階解碼器。
  • 評估範圍: 六個資料集、五個影像領域,採用五折交叉驗證。
  • 部署參考: 手機 Arm Mali-G52 MC2 上各版本達到完整 GPU 算子覆蓋,但延遲因版本而異。
項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, Image, Medical醫學, 庫

tactile:讓電子皮膚學懂接觸位置的拓撲感知模型

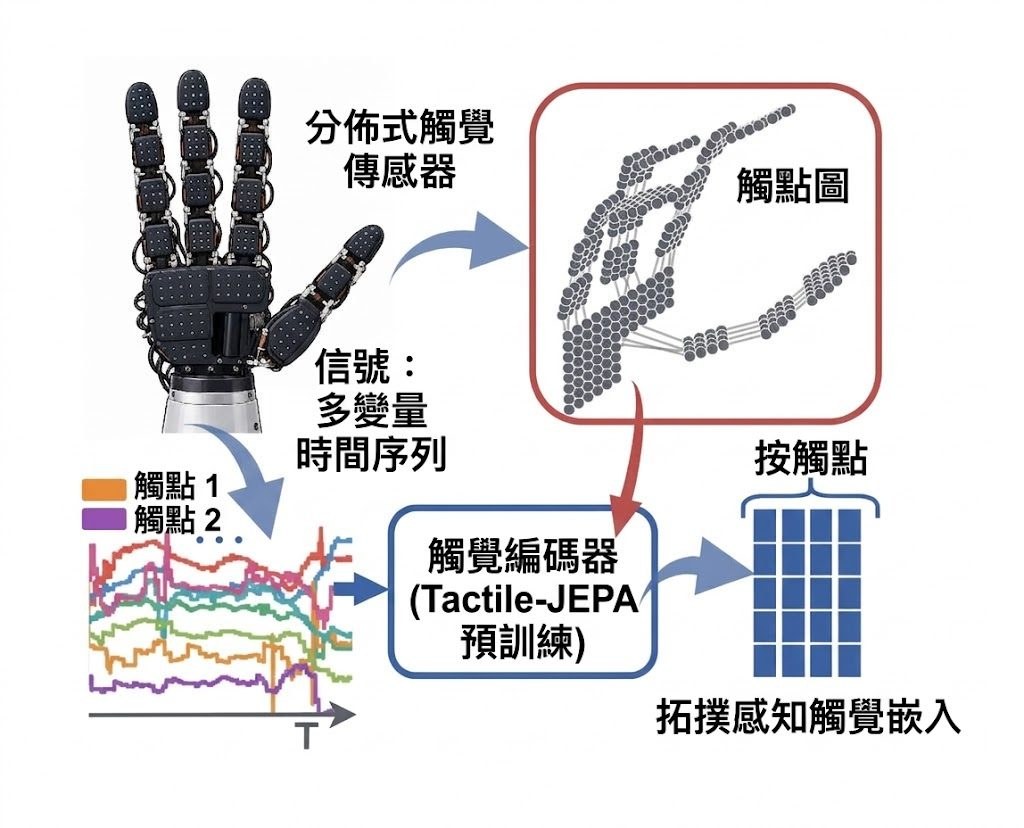
Tactile-JEPA 把分散式觸覺感測器的連接關係納入預訓練,令同一套表徵可支援力量、姿態及動作判斷。

Tactile-JEPA maps distributed tactile signals to topology-aware per-taxel embeddings using the taxel graph during pretra

電子皮膚面對的難題,不只是讀取感測數值,而是要理解哪些 taxel 彼此相鄰、接觸訊號如何在感測表面分布。Tactile-JEPA 屬於觸覺表徵學習模型,透過感測器拓撲預測被遮蔽的 taxel embedding,將原本分散的時間序列轉成可供下游任務重用的表示。

它沒有把感測面硬套成規則影像網格,而是沿着 sensor connectivity graph 抽取局部及全局遮罩;預設組合包含兩個 local masks 和兩個 global masks,兼顧局部接觸細節與整個表面的狀態。模型由 context encoder、exponential-moving-average (EMA) target encoder 和 predictor 組成,predictor 預測隱藏 embedding,再以 mean squared error 對齊 target encoder 輸出;預訓練完成後,凍結的 target encoder 可配合 task-specific heads 使用,而下游編碼不再需要圖結構。

項目涵蓋 Xela magnetic hand skins、piezoresistive tactile socks,以及雙手 DECO-50 等不同感測器形態,支援 force estimation、in-hand 及 full-body pose estimation、object/action classification 和 visuo-tactile policy learning。首頁報告指,模型相對各任務最強基線,in-hand orientation error 減少 20.8%,force estimation error 減少 6.3%,但預訓練模型及論文連結仍標示為 TBD,結果重現程度要視乎後續資源是否補齊。

測試需要 Linux、Conda 及具 CUDA-compatible driver 的 NVIDIA GPU,並由儲存庫建立環境、以 editable package 方式安裝。三個資料集合共涉及數百個 taxels,下載及整理成本不低,較適合研究觸覺感知、機械人操作或 visuo-tactile learning 的團隊;只需要單一感測器分類器的工作,未必能抵銷圖結構整理及 GPU 預訓練成本。

  • 以拓撲遮罩取代影像式規則遮罩,貼近不規則電子皮膚的實際排列。
  • Local 與 global targets 同時捕捉接觸細節及整體感測狀態。
  • 預訓練 encoder 可服務力量、姿態、物件及動作等多種下游任務。
  • 圖結構只參與預訓練,之後的編碼流程較容易接入不同任務。

項目主頁 · GitHub · 模型

Categories: 開源, Embedding, 模型, 模型訓練, Robotic, 庫, Dataset 數據集

FoMo 不用人手標註,讓影像更貼近感知

FoMo 借助 diffusion model 生成由淺入深的影像變體,免除大量人工標註,訓練出可比較兩張圖片感知差異的模型。

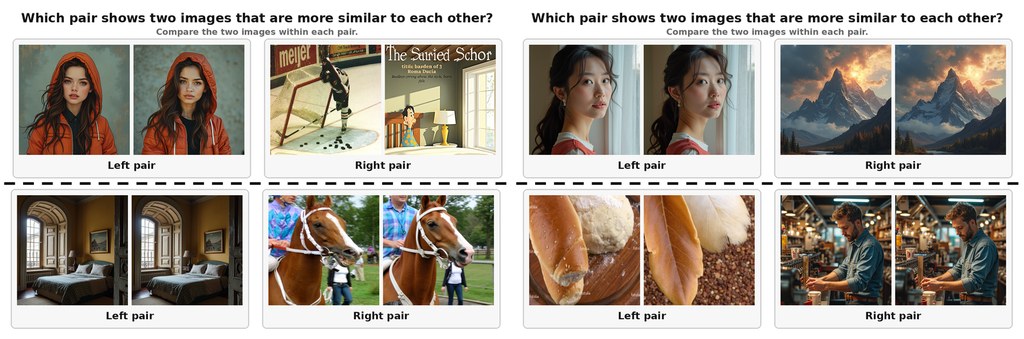
FoMo: data generation from the forking moment of the diffusion trajectory, and ranked-BCE training

比較原圖與修改版本時,像素差異未必等於人眼感受到的差異。FoMo 以 reference-based perceptual distance metrics(參考式感知距離模型)處理這個問題,透過 FLUX.1-dev 的 img2img 軌跡製造有次序的影像變體,並以此訓練影像品質評估(image quality assessment,IQA)模型,屬於開源模型項目。

它的關鍵做法,是在 diffusion model 的去噪流程中,於不同 denoising steps 重新接回生成軌跡。重新接入得越早,生成圖與原圖的感知偏離通常越大;這個 forking moment 便提供了密集而有排序的監督訊號。項目用 480k 組影像資料配合 pairwise ranking objective,減少依賴人手逐張標註的成本。

項目提供七個模式,涵蓋 LPIPS、DISTS、DreamSim,以及以 frozen DINOv3、CLIP、MAE backbone 配合 prediction head 的版本。DreamSim 透過 LoRA adapters 微調,而 dinov3、clip、mae 會把兩張圖片按次序讀入同一組 token;預設會計算兩個方向的平均分,處理輸出可能不對稱的問題。

  • lower score 代表兩張圖片更相似,raw 輸出也是公開評估採用的數值
  • output=’loss’ 可提供以 identity pair 為錨點的 perceptual loss
  • CNN 類模型使用固定 256px crop,DreamSim 使用固定 224px crop
  • DINOv3、CLIP、MAE 支援 64 至 256px 隨機裁剪,並以 zero-padding 和 attention masking 組批
  • 項目可透過 Python 套件 fomo-iqa 載入預訓練模型,直接比較參考圖與測試圖

FoMo 適合需要自動判斷生成圖片、編輯版本或重建結果相似程度的研究者與影像工具團隊。它的限制也很清楚:訓練訊號來自 FLUX.1-dev 的生成軌跡,不能直接等同人類偏好;不同 backbone 的輸出形式、裁剪策略與對稱處理亦會影響比較結果,因此應按工作流程選擇模型並自行驗證。

項目主頁 · GitHub

Categories: 開源, 模型訓練, Image, 影像處理, 工具, LoRA

morphometric:人手示範跨越機械手形態,直接訓練視覺操控策略

同一段人手操作示範,能否教會不同機械手抓握物件?Morphometric Imitation 嘗試保留接觸動作,再把示範轉成可在真實機械手執行的策略。

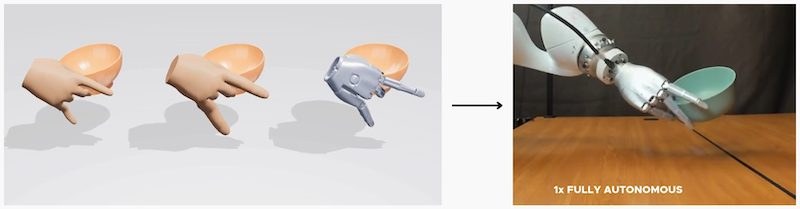
mmi teaser

讓不同機械手學習同一段人手抓握示範,難處不只是手指形狀不同,還要確保動作符合物理條件。Morphometric Imitation 是一套三階段機械人模仿學習框架,把重建的人手與物件互動(hand-object interactions,HOIs)轉成視覺運動控制策略,目標是毋須在真實環境再訓練便能執行。

框架先以形態優化(morphometric optimization,MMO)調整人手動作,盡量保留手指與物件的接觸位置;再用殘差強化學習(residual reinforcement learning,RL),結合示範中的物件姿態及接觸資訊,修正機械手未必做得到的動作。最後,系統把修正後的示範轉成依靠視覺輸入操作的策略,而非直接照搬人手軌跡。

Morphometric Imitation

在三款機械手、十種互動的測試中,MMO 的接觸 F1 分數在每款手上,都比五種比較方法中表現最好的一種至少高 8 個百分點;後續動態動作轉換的成功率最多提高 35 個百分點。不過,這些結果不能直接推算到其他機械手或未測試的物件。

  • 適合研究如何把人手示範轉移至多指機械手的團隊。
  • 核心取捨是增加動作修正步驟,換取可執行性及接觸保真度。
  • 物件姿態與接觸資訊各自有助於殘差 RL;消融測試顯示兩者作用互補。
  • 儲存庫目前表示程式碼稍後公開,未提供安裝或重現測試步驟。

項目網站提供影片和研究資料,可先用來了解示範涵蓋的物件與機械手動作。程式碼尚未釋出,現時無法按儲存庫自行部署或核對訓練流程。

項目主頁 · GitHub

Categories: 開源, 模型訓練, Robotic, 框架, 庫, 深度學習

Maestro:本地一鍵 AI 創作工作室,把導演、剪接、生成模型打包

Maestro 把 LTX-2.5、MiniMax H3 等本地模型整合成一個創作介面,配合 LLM 編寫分鏡並自動生成音樂影片與短片,適合想在自己機器上完成後期的人。

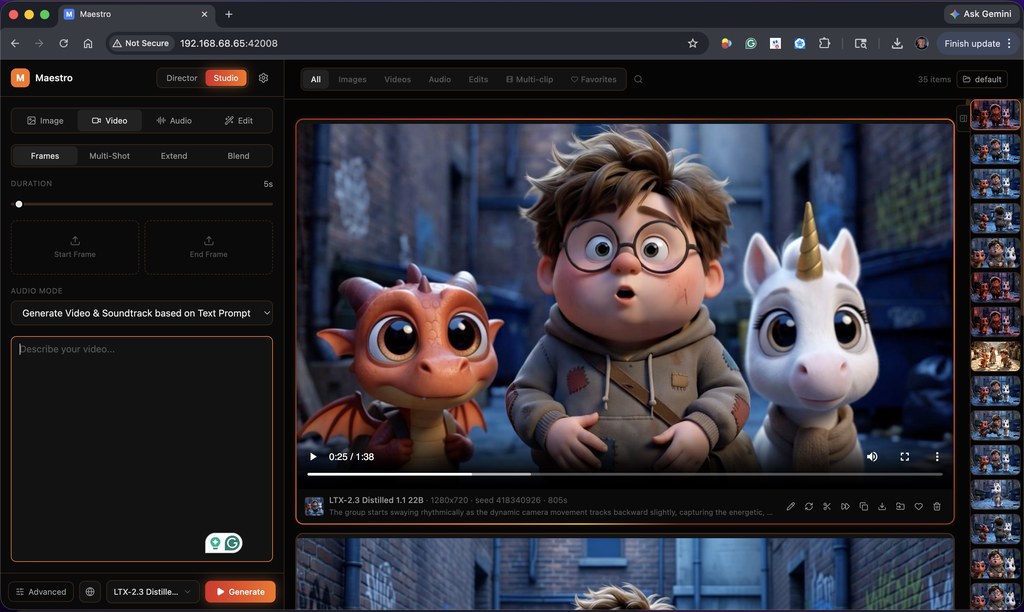
Maestro UI

用 LTX-2.5 或 Hunyuan 這類本地模型做創作時,最麻煩的往往不是模型本身,而是要自己串接腳本、分鏡、剪輯和多軌音訊。Maestro 直接把這條工作流收進一個桌面介面:LLM 先讀懂你的音訊或劇本,再交由圖像、影片、音訊模型接力生成。Director Mode 同時支援 Music Video(節拍感知分鏡)同 Short Film(劇本連戲)兩種套路,前者會分析 BPM 與段落(主歌、副歌、橋接),再把鏡頭對齊落拍;後者靠 pacing-bias slider 控制剪接密度,並維持角色與對白的一致性。Auto Mode 可以一鍵跑完整條 analyze → plan → generate → combine 流程,Manual Mode 則保留每一步檢查點。

Director v2 架構把編劇、結構化分鏡、模型格式化分成三層,H3 路徑直接走自家編譯器,其他模型則用 per-model polish。Studio 那邊亦提供適應性寫作與連戲指引,並對源動作、對白歌詞做一致性檢查。對比逐個 CLI 工具拼接的傳統做法,Maestro 的差異在於把 director 邏輯、prompt 優化同非破壞性多軌剪輯綁定在一處,省下不少膠水程式。

硬件門檻方面,Performance Auto-Tune 會在首次啟動時偵測 GPU、VRAM、RAM,並自動選取量化、VAE tiling 與 VRAM 安全係數;OOM 時還會彈出建議橫幅,一鍵降 headroom。Qwen Image 2.1 7B 支援最多十張參考圖、透明 PNG 輸出與專屬 prompt 增強,但屬研究/評估授權,商用要另外處理 Qwen 的授權。

重點摘要

  • 整合 LTX-2.5、MiniMax H3、Wan、Hunyuan、SCAIL-2 等本地模型作影片生成、延伸、混合、重拍、上色與 upscale
  • Director Mode 用本地 LLM 自動規劃音樂影片分鏡或短片劇本,並維持角色與對白連戲
  • Auto Mode 全自動、Manual Mode 每步可審;Performance Auto-Tune 依硬件自動選 profile
  • Qwen Image 2.1 7B 支援十張參考圖、透明 PNG,但僅研究/評估授權
  • 原始資料未提供具體安裝步驟或下載連結,需自行到倉庫頁查閱

內容生成後想拿來做音樂 MV、自媒體短片或概念分鏡的獨立創作者、小型工作室,會較容易受惠;商業團隊則要留意 Qwen 等模型的授權細節。Maestro 在 JavisBench、V ABench 等基準上對 LTX-2.3 的對比屬同捆支援模型本身的表現,工具層並未自稱有獨立 benchmark。

GitHub · Paper

Categories: 開源, 香港理工大學, 上海人工智慧實驗室, 騰訊, AI productions, 模型, Qwen, NVIDIA, Video, Image, Audio, 香港, 工具, Content Creator, LTX, 音樂, MiniMax

AV-GRPO 把音訊影片聯合模型訓練門檻壓到 8 張 A800

這個項目把 GRPO 強化學習帶進多模態模型,並透過「模態錨定解耦」大幅降低跨模態訊號干擾,連 LoRA 微調都能在 8 張 A800 上完成 22B 模型訓練。

Repository image for zhiyuxu03/AV-GRPO

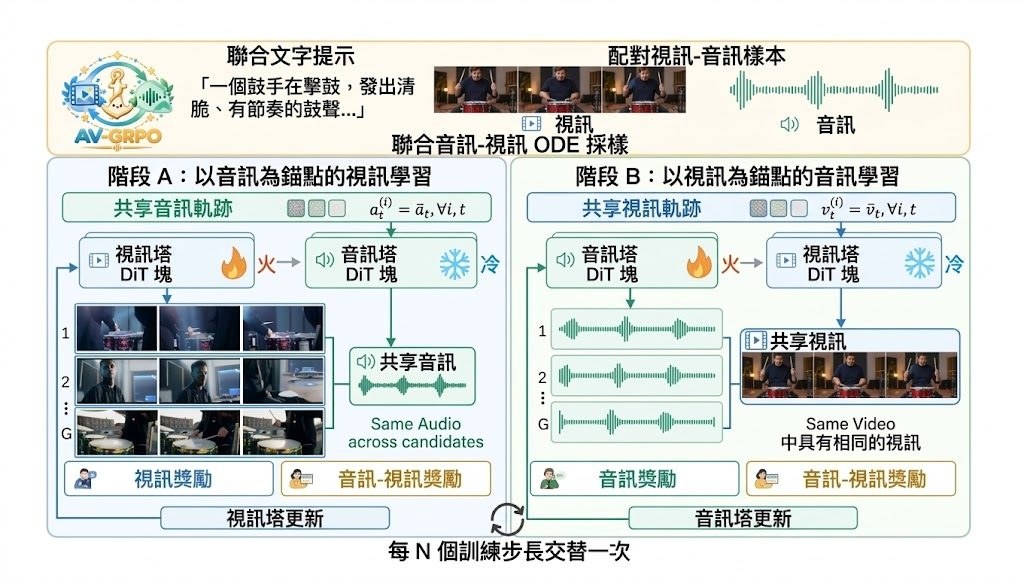
聯合音訊與影片生成一直有個麻煩:模型做出來的影像與聲音品質、文字對齊度、長度同步性常常此消彼長。AV-GRPO 直接把 GRPO 強化學習框架搬進 LTX-2.3 這類 22B 級的雙流模型,並用「模態錨定解耦」的方式,把音訊與影片兩路的學習訊號分開計算,避免強化學習的獎勵把兩個模態的功勞混在一起算不清。配套的 5DAV 數據集同樣沿五個維度拆解,方便精準控制訓練難度。

作者最在意的是算力門檻,這套框架支援全參數微調與 LoRA 微調兩種模式,只要 8 張 A800 就能跑得起來,並整合了模態錨定 rollout、凍結其中一路做軌跡鎖定優化、依模態特性調整擾動強度三個機制,把原本耦合的多模態偏好學習拆成條件式單模態子問題,使獎勵歸因與同步優化都更精準。

在 JavisBench 與 VABench 評測中,AV-GRPO 不論 LoRA 或全參數設定,於生成品質、語意對齊、跨模態同步三項都穩定超越 LTX-2.3 基準。對需要「一次到位」產出高同步影音的團隊、短片創作工具開發者、以及想在有限 GPU 資源下微調大型影音模型的實驗室,吸引力都很高。

重點摘要:

  • 首個針對音訊影片聯合生成設計的 GRPO 框架,解決強化學習獎勵訊號在異質模態間糾纏的問題。
  • 模態錨定解耦讓影片與音訊各自計算 rollout 與獎勵,顯著改善獎勵歸因。
  • 22B 模型在 8 張 A800 上支援 LoRA 或全參數微調,大幅降低硬體門檻。
  • 5DAV 數據集沿五個維度解耦,方便調節難度與做消融實驗。
  • JavisBench 與 VABench 結果顯示生成品質、文字對齊與跨模態同步全面優於 LTX-2.3。

官方尚未提供一鍵安裝或開箱即用的 inference 腳本,整合進 LTX-2 推論流程時仍需自行處理權重合併與路徑替換;對於想直接做線上服務的團隊,整合成本仍是主要取捨。

GitHub · Paper

Categories: 開源, 香港理工大學, 上海人工智慧實驗室, AI productions, 模型, 多模態模型, 模型訓練, NVIDIA, Video, Audio, 框架, 香港, 工具, LTX, Dataset 數據集, LoRA

阿里 WanPE 用 397B 參數重寫電影級提示詞

阿里 Wan Team 推出 397B 參數嘅電影級提示詞增強模型 WanPE,專門幫影片生成模型把簡單描述擴寫成導演級腳本。

Wan logo

用文字寫出導演水準嘅提示詞係一道高牆。普通用戶多數只會輸入「一個人喺森林行」,但頂級模型需要更細緻嘅鏡頭語言、動作編排同節奏控制,先至能夠生成高質素嘅 30 秒成片。阿里 Wan Team 推出嘅 WanPE,正正瞄準呢個痛點:佢會將用戶輸入嘅簡短描述,自動擴寫成包含鏡頭運動、燈光變化、動作節奏嘅電影級分鏡腳本,再交俾下游影片模型執行。

WanPE 採用「Video-grounded reverse construction」做法,先從真實影片反向建構出鏡頭規劃,再學習點樣由提示詞出發重建同樣嘅結構,比起由前向改寫提示詞更能保留導演意圖。同時,佢透過 Semantic-Consistency GRPO(SC-GRPO)訓練方法,確保長鏡頭、多分鏡之間嘅語意唔會走樣。整個模型以約 105 萬條真實影片訓練而成,參數量達到 397B。

沒有 WanPE

使用 WanPE 之後

團隊構建咗人類標註嘅 WanPEval 測試集,覆蓋 5 至 30 秒唔同時長同意圖粒度,並用約 11,000 組盲測配對評分做對比。當配搭 Wan3.0 影片生成器時,WanPE-397B 喺 5 至 15 秒影片將人類偏好分數提升 10.7 至 18.8 分;喺 30 秒嘅長片場景,偏好分數更大幅躍升 50.9 分。喺 5 至 15 秒組別,佢領先所有受測嘅商業方案;30 秒組別則與 Seedance 2.5 保持競爭水平。

對內容創作者、短影片團隊或者想做 AI 廣告片嘅人嚟講,呢類自動「導演助手」能夠省卻大量分鏡草稿時間;對開發者而言,佢亦可作為外掛增強模組,套用到 LTX-2.5、MiniMax-H3 等其他生成器身上做格式適配。

重點摘要

  • 397B 參數專職寫分鏡:WanPE 將用戶簡短提示擴寫為導演級電影腳本,再交俾下游影片模型執行
  • 逆向建構 + SC-GRPO:從真實影片反向學習鏡頭規劃,並透過強化學習保持長片語意一致
  • WanPEval 評測:人類標註、5 至 30 秒覆蓋、約 11,000 組盲測配對評分
  • 30 秒長片偏好激升:搭配 Wan3.0 時,人類偏好分數提升 50.9 分
  • 可遷移:經格式適配後,可應用於 LTX-2.5、MiniMax-H3 等其他生成器

項目主頁 · Paper

Categories: 南京大學, 清華大學, 阿里巴巴, AI productions, 模型, 模型訓練, Video, 提示詞, Content Creator, LTX, 中國, Dataset 數據集, MiniMax

OmniEcho:讓智能體真正「聽聲辨位」的全方位音視覺模型

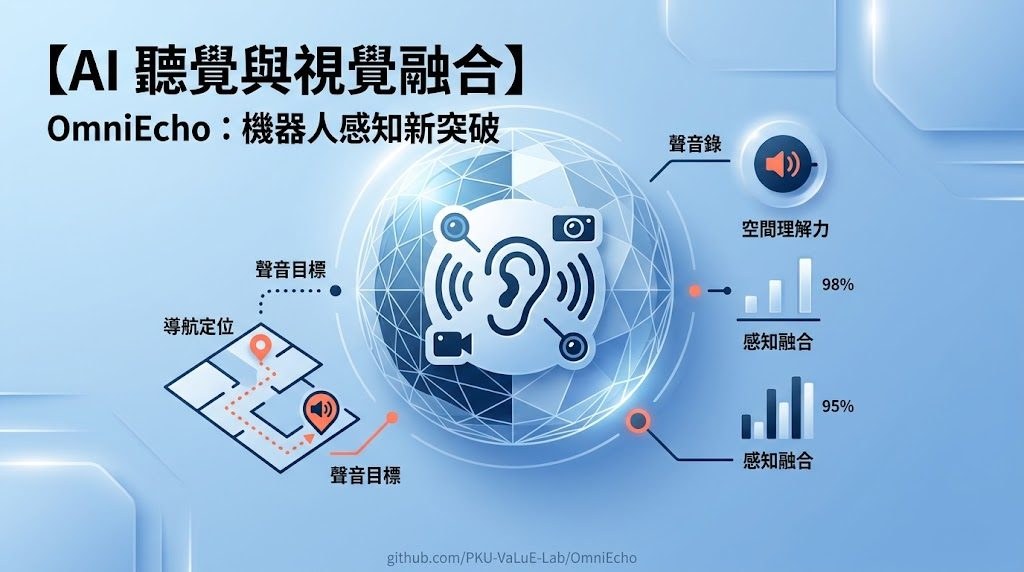
聲音從哪個方向來、距離多遠,是人類憑本能就能判斷的事,對機器人卻是一道難題。OmniEcho 把一階 Ambisonics 空間音訊、視覺與語言整合到同一個智能體,專門研究這類空間感知與聲源導航。

Repository image for PKU-VaLuE-Lab/OmniEcho

OmniEcho 是一個面向 embodied agent 的音視覺空間感知項目,由北京大學 PKU-VaLuE-Lab 開源。它要解決的問題很直觀:當一個智能體同時聽到聲音、看到畫面,它能否判斷聲源在哪個方向、距離多遠,並進一步循聲走去?這件事對人類毫不費力,但要讓 AI 真正做到,過去並不容易。

項目同時提供三樣東西:統一基準 OmniEchoBench、可控的空間音訊渲染管線,以及基於 Qwen3-Omni 改進的 OmniEcho 模型。後者最關鍵的設計,是在 Qwen3-Omni 既有語意音訊通路之外,加掛一個專門處理 FOA(一階 Ambisonics)空間資訊的編碼器,讓模型同時理解「聽到什麼」和「聲音從哪來」。

基準涵蓋六類任務,合共 197 個真實音視覺場景、2,972 條 QA 與 900 條導航樣本,全部由人工核對標註。OmniEcho 在空間音視覺感知上達到 state-of-the-art,而循聲導航的表現已經逼近傳統「靠文字指示」的視覺語言導航。不過細粒度的方位判定與距離估計,仍被作者列為尚未解決的難題。

對做機器人導航、音視覺融合研究,或需要智能體在真實場景中聽聲定位的團隊,這套項目提供了一個可以直接拿來跑評測、訓練、再挑戰的起點。原文並未附上完整的安裝或下載流程,相關代碼與模型權重目前標示為即將釋出。

重點摘要

  • 空間音訊加視覺語言:以 FOA 為輸入,與視覺、語言一起餵進 omni-modal agent。
  • 雙編碼器設計:在 Qwen3-Omni 之上新增 FOA 空間編碼器,保留原有語意音訊能力。
  • 真實世界基準 OmniEchoBench:六類任務、近 3,000 條 QA 與 900 條導航樣本,人工核對。
  • 循聲導航貼近文字導航:在 Nav 任務上接近傳統 VLN 水平,但方位與距離仍偏弱。
  • 代碼與權重待發佈: 標示 Coming Soon,暫無公開安裝步驟。

GitHub

Categories: 開源, 北京大學, Agentic, 模型, 視覺模型, 模型訓練, Qwen, VLA, Audio

object-permanence:讓世界模型學識記住被遮擋嘅物件

透過 150 個 Blender 任務同 150 萬條訓練樣本,訓練一個 16B 世界模型喺物件被遮擋時仍能保持記憶,處理視頻生成中常見嘅「物件消失」問題。

Training Object Permanence in World Models

當一件物件被屏幕或牆壁擋住再出現時,現時嘅世界模型往往會「忘記」佢原本嘅樣貌同位置。PWM-WROP 正正針對呢個限制:佢係一個基於 NVIDIA Cosmos3-Nano 微調嘅 16B 多模態世界模型(Multimodal World Model),專門訓練物件永續性(object permanence)——即係物件即使被遮擋都要喺內部表示中保留落去。

訓練數據嚟自一個 Blender 渲染嘅數據工廠,包含 150 個任務生成器,涵蓋六大認知家族,例如 turntable_behind_screen_task 等。每個樣本會輸出五件檔案:input_video、target_video、prompt、trajectory.npz 同 metadata.json,方便用嚟做 video-to-video 監督學習。整個訓練用原生 PyTorch(避免 XLA graph tracing)喺 AWS Trainium2 上跑,透過 tensor parallel × FSDP2 跨 64 個 NeuronCore。

對於從事物理推理、機器人模擬或影片生成嘅團隊呢個項目特別有用——佢直接提供可生成嘅訓練數據、預訓練權重(BF16,約 15B 參數)同 benchmark(WROP 300 題),減少由零建立物件永續性測試嘅成本。Hugging Face 上面已有模型。

重點摘要:

  • 數據規模:150 個 Blender 任務生成器,每個 20 條樣本,合共約 150 萬條 video-to-video 訓練數據
  • 模型規模:PWM-WROP 為 16B 參數(FP16 約 15B),基於 Cosmos3-Nano 微調
  • 硬件要求:訓練需要 AWS Trainium2(trn2.48xlarge,64 NeuronCore),推論則視乎部署方式
  • 授權限制:採用 CC BY-NC 4.0,僅限非商業使用,商用需另行聯絡作者
  • 生態整合:配搭 WROP 300 題 benchmark,可以量化唔同影片模型嘅物件永續性表現

同一般只做外觀預測嘅世界模型相比,PWM-WROP 強調「被遮擋都要記得」,並透過軌跡數據(trajectory.npz)提供逐幀 ground truth 做監督,對於需要物件級別一致性嘅應用場景(例如機械臂操作預演、視頻預測品質提升)會有明顯幫助。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 多模態模型, 視頻模型, 世界模型, NVIDIA, Video, Python, Dataset 數據集

影像上載漏洞連上 SSO 缺陷,研究團隊取得 OpenAI 內部存取權

一張經論壇上載的圖片,可能令攻擊者由影像處理漏洞一路觸及員工帳戶及內部程式碼庫。Hacktron AI 的研究描述了兩個弱點如何串連成攻擊鏈。

Og image

Hacktron AI 的研究展示了一條由論壇圖片上載通往內部程式碼庫的攻擊鏈:影像處理元件的 heap buffer overflow,配合 OpenAI SSO 設定缺陷,令研究團隊聲稱曾接管多名員工的 ChatGPT 帳戶,並取得內部程式碼庫存取權。這類案例提醒管理者,單一漏洞的影響可能延伸至已連接的服務與帳戶。

攻擊鏈由 OpenAI 社群論壇 community.openai.com 開始。論壇處理圖片時會使用 ImageMagick,而它依賴的 libheif 存在堆積緩衝區溢位;研究亦指出,Debian 套件缺少相關安全修補。研究團隊再把這個漏洞與 SSO 身分驗證配置問題串連,進入 ChatGPT 及 Codex 帳戶。

取得帳戶後,連接到 ChatGPT 或 Codex 的服務亦可能擴大受影響範圍,包括 GitHub 及內部程式碼庫。團隊稱,他們透過員工的 Codex 在 OpenAI 內部 monorepo 開啟 PR,以證明存取能力,同時避免讀取敏感資料;這說明第三方連接器與帳戶權限會左右漏洞的實際影響。

對負責論壇、影像處理套件或企業登入整合的安全團隊,這宗披露可作為檢查線索:
– 確認 libheif 等相依套件已套用安全修補。
– 檢查 SSO 設定及帳戶接管防護。
– 盤點 ChatGPT、Codex 等服務連接的外部工具與權限。
– 測試由公開上載入口通往內部服務的完整攻擊路徑。

文章標示的披露日期為 2026 年 9 月 13 日,並列有受影響版本及修補資訊章節;但提供的內容未包含版本號、修補細節或獨立評估結果,因此不宜據此推斷所有部署均受影響。重點在於,影像解碼漏洞與身分驗證設定問題一旦串連,風險便可能超出原本的上載功能。

項目主頁

Categories: OpenAI, 新聞, 安全

Page 1 of 160
1 2 3 … 160