面對一段很長的文章、一張表格或一段影片,問題通常只需要其中一小部分證據,但過度保留會浪費讀者的上下文,剪得太細又可能失去理解線索。CANOPY(Canonical Projection over Hierarchy)是 POSTECH 提出的多模態 RAG 後檢索證據壓縮框架,按項目內不同區域決定保留範圍。
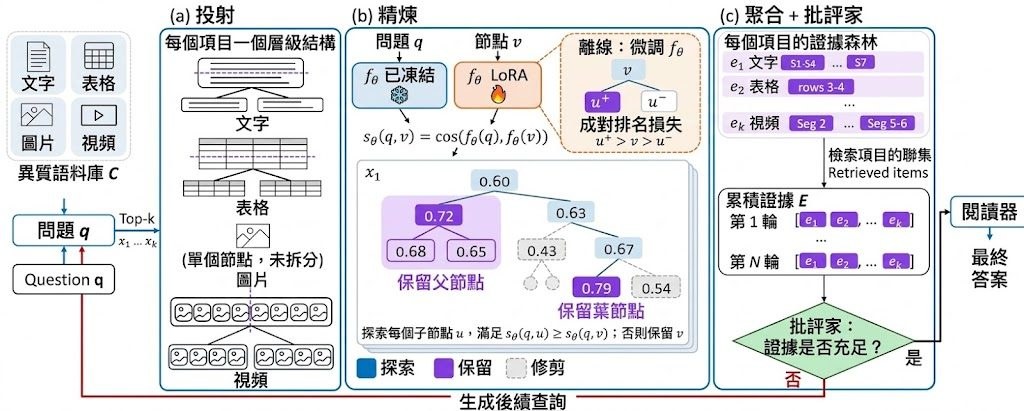
CANOPY 會把每個檢索項目整理成層級結構,再以經 gold evidence 微調的 node encoder,按照查詢評分不同區域。系統會比較子區域與父區域的相關程度,保留句子、表格列、關聯文字或影片片段等合適粒度,而非為整個項目套用單一截取規則。
保留的證據不足以回答問題時,critic 會要求針對性追加檢索;新找回的項目同樣先經壓縮,再加入讀者輸入,減少無關內容反覆累積。這個設計亦處理了壓縮本身無法補回「從未檢索到的證據」這項限制。
- 在五個 QA benchmark、包含 3,300 萬個異質項目的語料庫上,平均答案準確率高於參與比較的檢索基線。
- 消融結果顯示,多跳問答的準確率提升主要來自追加檢索。
- 在未經路由的 Qwen3-VL-8B-Instruct 讀者設定中,證據 token 輸入量減少 14.2% 至 27.7%。
- 壓縮後答案準確率保持相若,適合需要同時處理文字、表格及影片的 RAG 工作流。
CANOPY 的價值不在於單純縮短檢索結果,而在於讓每個項目內的保留範圍跟隨證據位置及上下文需要變化。它仍受初始檢索品質限制,但對多跳查詢和長內容閱讀,可在保留可解釋線索的同時降低 reader 的輸入負擔。